MindBridge知识库py4
来源:飞书 Wiki 文档,逆向提取于 2026-11-19。
[!NOTE] 知识库会持续更新!面经也会持续更新
[!NOTE] 1、Langgraph的共享state多agent编排比较像workflow,这个agent runtime已经删除了,目前默认的agent runtime是自研的事件驱动多agent协作
2、本项目不一定要使用我给大家的微调后的模型ollama本地部署。大家可以用自己有api key的任意模型,qwen、deepseek、gpt5.6这些都可以。没有apikey的也可以上阿里云百炼上免费领一下
一、🎾项目简介与简历写法
MindBridge智能体
项目简介:面向心理场景开发的多Agent智能体平台,支持意图路由、心理知识检索、风险识别与高风险预警闭环。系统基于自研事件驱动多Agent runtime实现,并通过Agent Runtime Harness统一处理输入脱敏、agent调用、工具后处理、报告落库与run trace
- 技术栈:Python、FastAPI、Harness Engineering、Skill、Redis、Chroma、MCP、Docker、MySQL、RAG、SQLAlchemy、Basic Auth
- 负责功能: 1. Agent Runtime Harness 设计:设计并实现MindBridgeAgentHarness,将Agent Runtime、数据库落库和工具后处理解耦,统一处理Agent调用、报告生成、运行trace保存、消息持久化和工具计划生成。 1. 多Agent协作:设计基于CollaborationBlackboard的事件驱动协作机制,由CoordinatorAgent 维护任务板,多Agent根据能力claim任务并发布artifact,并通过SafetyAgent审查后由CoordinatorAgent最终采纳。 1. Engineering Harness建设:建设一键工程验证Harness覆盖六类核心链路。LLM-as-Judge从六个维度进行评分,被测模型与Judge模型解耦。RAG 评测HitRate 为 0.9667,MRR 为 0.9083。构建100条意图识别评测集,高风险召回率达93%,总体准确率达96%,平均首字延迟从5s降低到1.6s 1. 上下文管理与压缩:分层记忆机制,短期上下文优先从Redis读取,缺失时MySQL回填。实现历史窗口裁剪、摘要压缩和最近对话保留策略,生成memoryBrief与受限长度的 modelHistory,避免长对话下prompt膨胀。 1. 业务 Skill:通过 MindBridgeSkillRegistry动态加载SKILL.md。高风险场景强制叠加安全处理计划,生成个案交接摘要,提升回复策略的可审计性和可测试性。 1. MCP与异步任务队列:封装Excel写入、预警发送、备注追加等MCP工具,并实现异步工具队列处理高风险后置任务。队列支持幂等创建、限流、失败重试和dead letter,避免工具调用阻塞学生端流式回复。 第二版:
SentinelDesk 企业智能客服平台
项目简介:面向企业客户服务场景开发的多 Agent 智能体平台,支持用户意图路由、企业知识检索、客诉风险识别及高风险工单预警闭环。系统基于自研事件驱动多 Agent Runtime实现,并通过 Agent Runtime Harness 统一处理输入脱敏、Agent 调用、工具后处理、业务数据落库与 Run Trace。
- 技术栈:Python、FastAPI、Harness Engineering、Skill、Redis、Chroma、MCP、Docker、MySQL、RAG、SQLAlchemy、Basic Auth
- 负责功能: 1. Agent Runtime Harness 设计:设计并实现AgentHarness,将 HTTP/SSE 接口、Agent Runtime、数据库持久化和工具后处理解耦,统一完成输入脱敏、会话解析、Agent 调用、风险报告生成、Run Trace 保存、消息持久化及工具计划生成。 1. 多 Agent 协作机制:设计基于Blackboard的事件驱动协作机制, CoordinatorAgent 维护任务板,多 Agent 根据能力置信度 Claim 任务并发布 Artifac,候选回复通过 SafetyAgent 审查后,由 CoordinatorAgent 完成冲突仲裁与最终采纳。 1. Engineering Harness 建设:建设一键式工程验证 Harness,覆盖风险安全、Agent 路由、Standard Skills、RAG、API 和 Tool Queue 六类核心链路。LLM-as-Judge从六维评分,被测模型与Judge模型解耦。 1. 上下文管理与压缩:设计分层记忆机制,短期上下文优先从 Redis 读取,缓存缺失时从 MySQL 回填;实现历史窗口裁剪、摘要压缩和最近对话保留策略,生成 MemoryBrief 与受限长度的 ModelHistory,控制长对话场景下的 Prompt 长度和 Token 消耗。 1. 业务 Skill 体系:通过 MindBridgeSkillRegistry 动态加载 SKILL.md,将服务规范、风险处置规则和人工交接要求从代码中解耦;高风险客诉场景强制叠加安全处置 Skill,并生成标准化工单交接摘要,提升回复策略的可审计性和可测试性。 1. MCP与异步任务队列:将业务台账写入、风险工单创建、预警发送和跟进备注等能力封装为 MCP工具,并实现异步 Tool Queue 处理高风险后置任务;队列支持任务依赖、幂等创建、限流、失败重试和 Dead Letter,避免外部工具调用阻塞客户端 SSE 流式回复。
二、🥝前置知识
情绪标签、情绪分数和风险等级
[!NOTE] 本项目里情绪标签有这4类,正常、焦虑、低落和高风险
情绪分数也有4类,放在下面了
正常 0分
焦虑 2分
低落 3分
高风险 4分
风险等级3类,低中高,这里我把低中高风险等级怎么得到的给大家讲一下,因为这个项目只有单模态,如果情绪标签是正常or焦虑,情绪分数为0~2.9,则低风险,标签为低落,分数为3~3.9.标签为高风险,分数>=4,则为高风险
SSE流式会话
Server-Sent Events(服务器推送事件),是一种基于 HTTP 的实时通信协议。大模型生成文本通常是逐字逐句输出的,而不是一次性生成完毕。
通信方向为服务器 → 客户端单向推送
SSE 允许服务器将生成的内容像打字机一样源源不断地推送给前端浏览器或者App。这是实现类ChatGPT打字机效果的核心技术,相比 WebSocket 更轻量,适合单向流式传输。
这里给出SSE与WebSocket的对比
| 特性 | SSE | WebSocket |
|---|---|---|
| 通信 | 单向 | 双向全双工 |
| 协议 | HTTP | 独立 WS 协议 |
| 重连 | 浏览器自动重连 | 不支持,需手动编码 |
| 数据 | 仅文本 | 文本 + 二进制 |
| 大模型场景 | 纯文本流式输出 | 复杂场景,实时工具调用 |
| 开发成本 | 极低 | 高 |
MCP
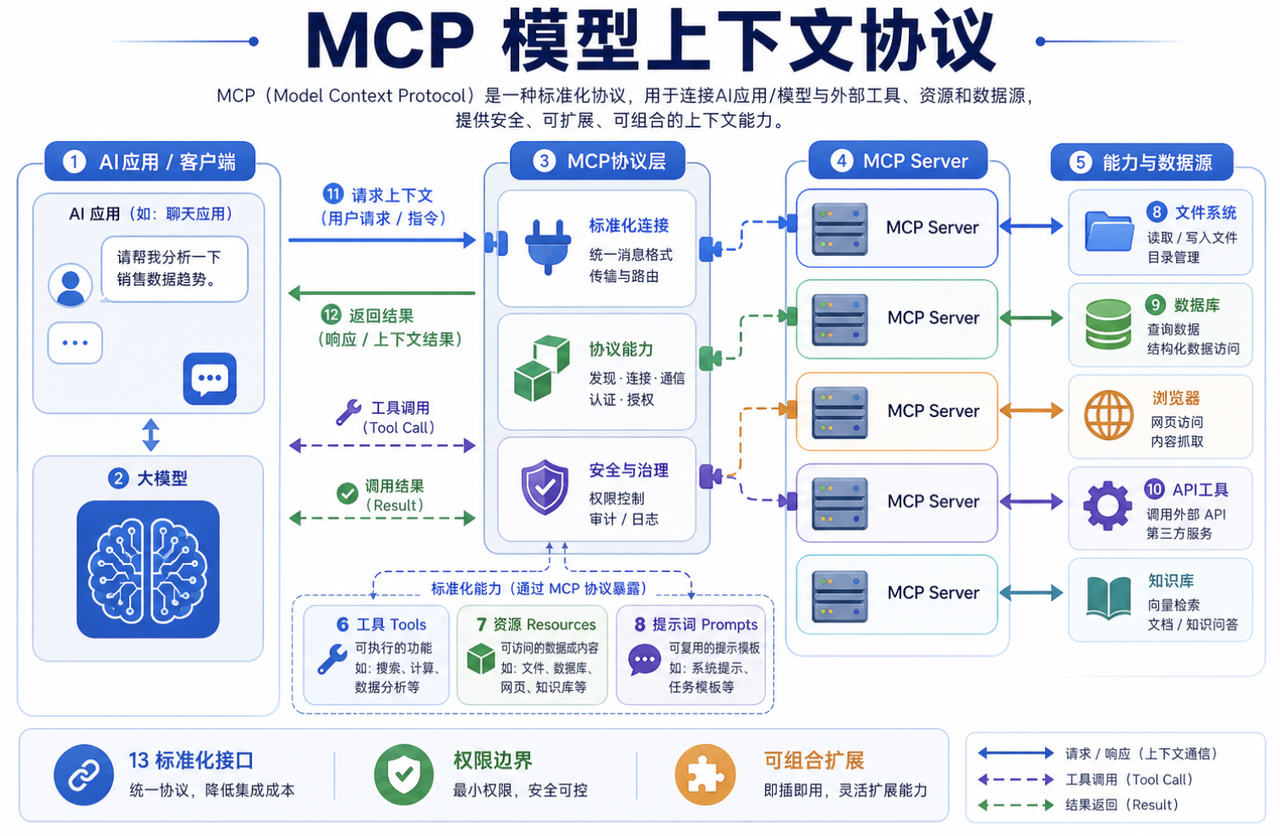
[!NOTE] - Model Context Protocol模型上下文协议,由 Anthropic,也就是Claude 团队推出。解决大模型与外部数据源、工具之间的连接标准问题。通过 MCP,一个 LLM 可以统一接入各种 MCP 服务器, GitHub、本地文件系统这些,实现更安全的上下文交互,避免开发者需要为每一个数据源写定制化的代码。
Ollama和OpenAI
[!NOTE] 本地部署 与 云端 API 两种使用大模型的方式。
- Ollama是一个极简的本地大模型运行工具。让你可以一条命令在本地运行 Llama 3、Qwen、Gemma 等开源模型。
- OpenAI提供闭源商用模型,GPT-4o, GPT-4o-mini 等的云端 API。优势是性能强大、开箱即用,但需要网络访问且按 Token 计费。
Lora微调大模型
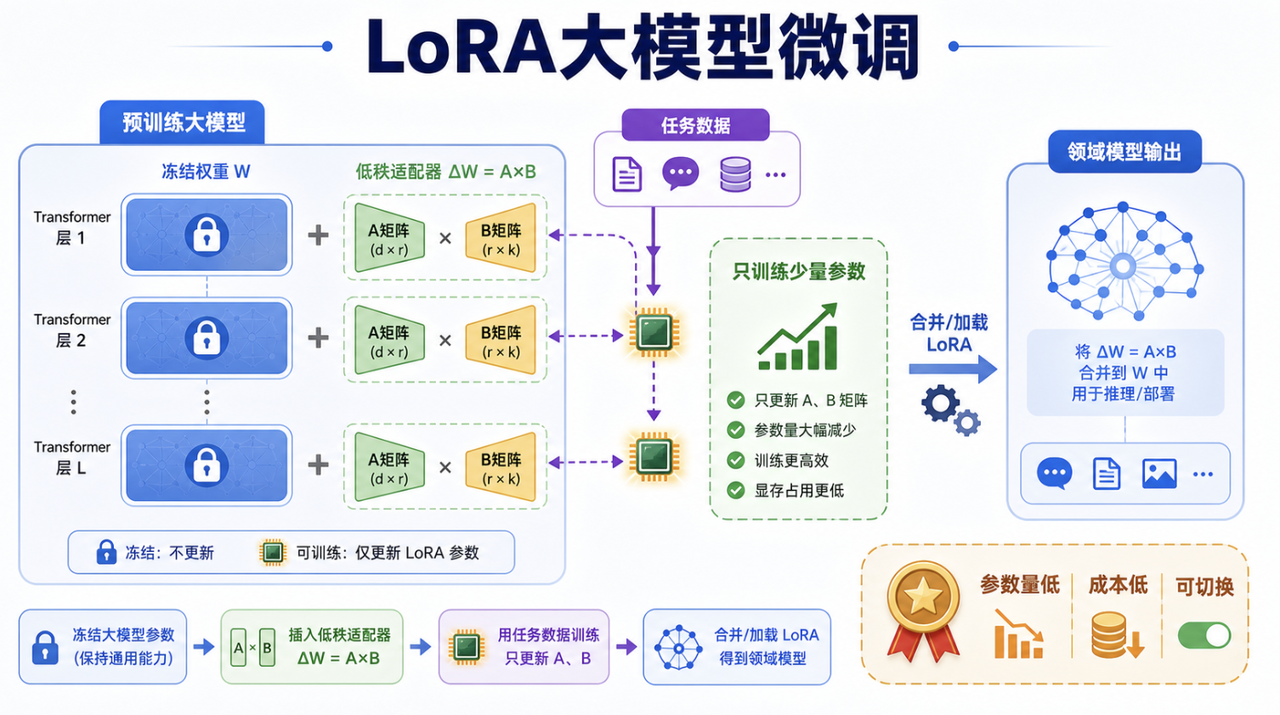
[!NOTE] - Low-Rank Adaptation低秩适应,一种轻量级大模型微调技术,不训练全量参数。 - Lora 通过在原始模型旁路添加少量的可训练参数(适配器),冻结原模型权重。只需训练原模型参数量 0.1%-1% 的参数,就能让模型学会特定风格、特定知识或特定格式的输出。 - 在 Transformer 层插入小的低秩矩阵,只训练这部分。显存占用小、速度快、保存的模型文件极小,几 MB~百 MB。 - 作用是让通用模型变成“心理顾问”或学习特定语气风格
这里先给大家详细讲一下LoRA微调
LoRA的核心创新的是发现了大模型在学习新下游任务时,其权重矩阵的更新量ΔW具有低秩特性。通俗来讲,大模型的成千上万个参数并非独立运作,而是存在同步联动的规律,复杂的高维权重空间变化,可通过两个低维矩阵的乘积近似表示
预训练模型的某一核心层的权重矩阵为W,维度通常为d×d,d为模型隐藏层维度,微调时的权重更新量ΔW可表示为两个低秩矩阵A和B的乘积,即ΔW = B×A,其中
- A矩阵:降维矩阵,维度为d×r,r为低秩维度,通常取8、16、32等小数值,随机初始化
- B矩阵:升维矩阵,维度为r×d,初始化为全0矩阵,确保初始状态下ΔW为0
- r低秩维度:核心控制参数,r越小,参数量越少,训练成本越低,反之则参数量增加,拟合能力增强但过拟合风险上升。 最终,微调后模型的输出为h = Wx + (α/r)×(B×A×x),其中α是缩放系数,用于平衡LoRA增量与原始模型输出的权重,确保微调效果的稳定性。
举个栗子,原始权重矩阵W为4096×4096,直接修改需调整约1680万个参数,当r=16时,A矩阵为4096×16约6.5万个参数,B矩阵为16×4096约6.5万个参数,总共仅需调整13.1万个参数,仅为原始层参数的0.78%
LoRA微调流程
先对原始的 PsyQA 数据集做数据清洗、去重、弱监督标注(注:弱监督标注和置信度我在微调细节章节有讲),只保留情绪表达清晰的对话数据,最终得到 2000 多条高质量样本。
然后把数据集按 9:1 划分为训练集和验证集,训练集用于 LoRA 微调,验证集用来评判效果、防止过拟合。
接下来加载基座模型 Qwen2.5‑7B,固定主干参数不更新,只在 Transformer 的 Attention 层插入 LoRA 适配器。超参数的话我设置的 rank=8,学习率 2e-4
训练过程中,每一轮都会在验证集上评估情绪标签的准确率,只保存效果最好的一轮权重,而不是最后一轮。
训练完成后,导出轻量化的 LoRA 权重文件,只有几十 MB,和基座模型一起加载部署到ollama里
[!NOTE] 这里给大家讲一下QLoRA
QLoRA是基于LoRA改进的参数高效微调PEFT方法。将预训练大模型的基座权重以4位精度量化并冻结,仅在模型关键线性层插入低秩适配器LoRA Adapter,通过反向传播仅训练这些少量适配器参数,从而在大幅降低显存占用的同时,保持接近16位全精度微调的模型性能,实现低成本、高性能的大模型定制化微调。
简单来说,QLora是量化技术+LoRA技术的双重优化组合,用量化压缩基座模型的内存占用,用LoRA实现高效参数更新,解决传统微调显存需求高硬件门槛高的痛点
RAG
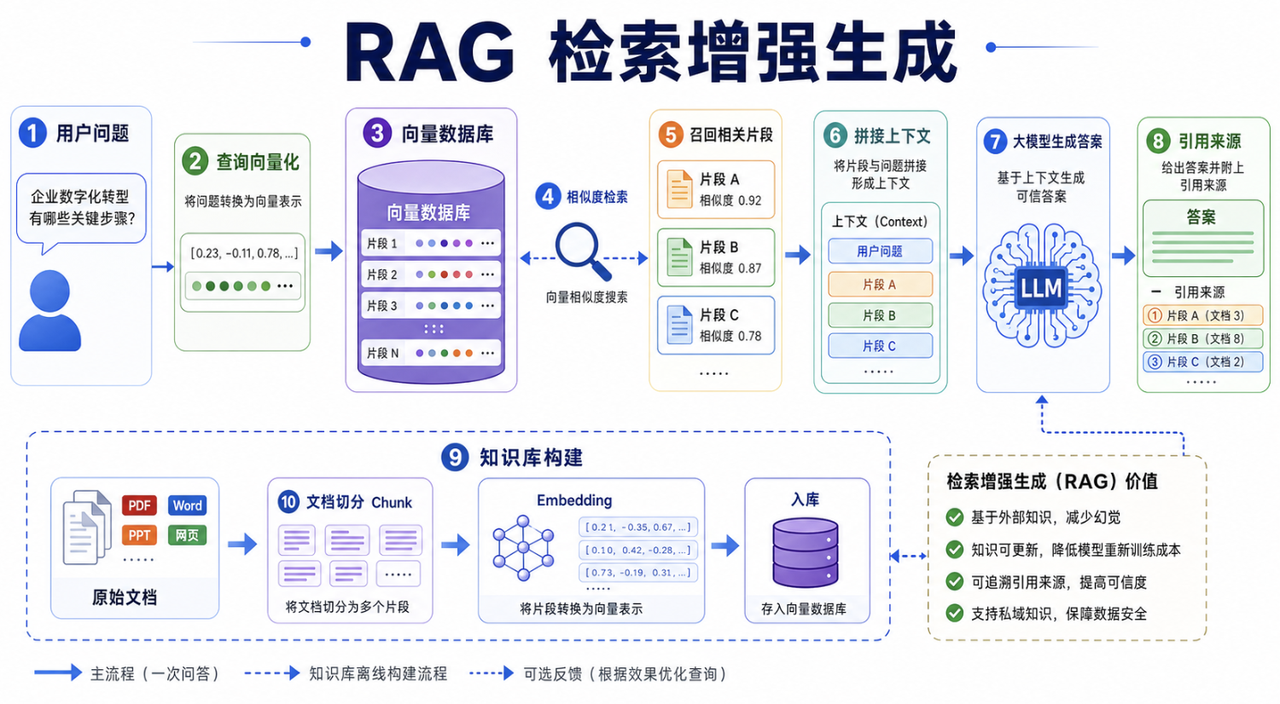
[!NOTE] - Retrieval-Augmented Generation。在让 LLM 回答问题前,先从外部知识库、向量库中检索相关的文档片段,将这些片段作为参考资料连同问题一起发给 LLM。 - 核心作用是解决 LLM 的幻觉问题和知识滞后性。让模型可以回答私有数据(公司内部文档等)相关的问题。
这里给0基础的同学详细讲一下RAG,有基础的同学可直接跳过
[!NOTE] RAG 工作流程
RAG 的工作流程可分为离线准备阶段,即构建知识库和在线推理阶段,即检索+生成,两个阶段相互独立,离线准备完成后,在线推理可实现秒级响应
构建知识库
离线准备是 RAG 生效的基础,核心是将原始文档文本、PDF、Word、Excel 等处理成可被检索的结构化向量数据
文档采集与清洗
[!NOTE] - 文档采集:收集需要纳入知识库的所有原始数据,包括企业内部文档产品手册、员工手册、合同模板、公开数据行业报告、政策文件、百科知识、实时数据新闻、动态公告等。 - 文档清洗:去除无关内容,比如说广告啊、冗余段落啊、统一文档编码、处理特殊字符,确保文档内容的准确性和规范性。对于 PDF、图片类文档,需通过 OCR 技术将图片转为可编辑文本。
文档切分Chunking
原始文档通常篇幅较长,直接向量化会导致向量维度冗余、检索精度下降,因此需要将文档切分成小的语义片段chunk
- 切分原则:以语义完整性为核心,确保每个 Chunk 包含一个完整的知识点,比如一个产品功能、一个问题的解决方案,避免切割后语义断裂。
- 常见的切分方式: 1. 固定长度切分:按固定字符数或者Token 数切分,比如每 500 字符、100 Token 切分,但是可能破坏语义完整性。 1. 语义切分:基于段落、句子、标题进行切分,比如按“。”“!”“?”分割句子,按“一级标题”“二级标题”分割段落。语义完整,检索精度高,是目前主流的切分方式。 1. 智能切分:结合 NLP 技术语义相似度、实体识别,自动识别语义边界,实现动态切分,比如说识别到一个完整的产品介绍后,自动切割为一个 Chunk,适用于复杂文档。
- 切分参数建议:Chunk 长度通常设置为 200-500 Token,中文约 150-375 字,同时保留上下文重叠,避免因切割导致的信息丢失。
向量化Embedding
计算机无法直接理解文本语义,因此需要通过 Embedding嵌入技术将每个 Chunk 以及文档的元数据,转化为低维稠密的向量。
向量的核心特点是,语义相近的文本,其向量在向量空间中的距离越近,语义无关的文本,向量距离越远,这是后续相似度检索的基础。
- Embedding 模型选择:
- 开源模型:BERT、Sentence-BERT、m3e-base、E5、BGE 等,可本地化部署,适合私有数据场景。
- 闭源 API:OpenAI Embeddings、百度文心 Embedding、阿里通义 Embedding 等,无需部署,调用便捷。
- 向量维度:常见维度为 768、1024、1536,维度越高,语义表征越精准,但存储成本和检索速度会下降。
入库
将切分后的 Chunk 向量、原始文本、元数据一起存储到向量数据库中。向量数据库与传统关系型数据库、非关系型数据库的核心区别是支持高维向量的相似度计算和快速近似最近邻搜索ANN。它可以在百万、千万级向量中,快速检索出与查询向量最相似的 Chunk。
补充:若暂无向量数据库,可临时使用轻量开源工具Chroma、FAISS存储,但生产环境,还是应该使用企业级向量数据库 Milvus、Qdrant、Pinecone,保障检索性能和稳定性。
维护持续更新
离线准备并非一次性完成,需要建立知识库维护机制,新增文档时,重复清洗、切分、向量化、入库流程。当删除或者修改文档时,同步删除or更新向量数据库中的对应数据
检索&生成
当用户提出问题后,RAG 系统通过以下步骤生成答案,全程可实现秒级响应
接收&预处理
接收用户输入的自然语言问题,进行简单预处理,去除无关字符、纠正错别字
问题向量化
使用与离线准备阶段相同的 Embedding 模型,将用户的问题转化为向量,确保问题向量与知识库中 Chunk 向量的语义空间一致,避免检索偏差。
相似度检索
将查询向量输入到向量数据库中,通过近似最近邻搜索ANN算法,检索出与查询向量最相似的 Top N 个 Chunk,通常 N=3-5。检索的核心指标是召回率,即能否检索到所有与问题相关的 Chunk、精确率,即检索到的 Chunk 是否与问题真正相关。
检索优化
元数据过滤
结合元数据文档类型、创建时间、所属部门进行过滤,缩小检索范围
混合检索
将向量语义检索与关键词检索结合,向量检索负责语义匹配,关键词检索负责精准匹配,提升检索精度。
重排Reranking
对检索到的 Top N Chunk 进行二次排序,通过重排模型比如 Cross-BERT计算 Chunk 与问题的精准匹配度,将最相关的 Chunk 排在前面,减少冗余信息。
Prompt 构造
将用户问题、检索到的 Top N Chunk 原始文本,按照固定格式拼接成 Prompt,输入到大模型中。Prompt 的构造直接影响大模型的输出质量,核心原则是明确指令、提供充足事实、约束输出格式。
给个Prompt 模板:
请基于以下提供的参考资料,回答用户的问题。要求:1. 严格按照参考资料中的内容回答,不添加任何未提及的信息,避免编造2. 语言简洁、准确,分点清晰(若有多个要点)3. 若参考资料中没有相关答案,直接回复“暂无相关信息”,不要猜测。
参考资料:
[Chunk 1] ......(检索到的第一个 Chunk 原始文本)
[Chunk 2] ......(检索到的第二个 Chunk 原始文本)
[Chunk 3] ......(检索到的第三个 Chunk 原始文本)
用户问题:{用户的具体问题}
可根据场景优化 Prompt,如添加引用来源,要求答案末尾标注参考资料的文档标题和来源、格式约束,要求以表格、分点形式输出。
大模型生成答案
将构造好的 Prompt 输入到大模型中,大模型基于参考资料,检索到的 Chunk进行理解和生成,输出符合要求的答案。此时,大模型的输出被严格约束在检索到的事实范围内,可以有效避免幻觉。
动态路由RAG
[!NOTE] 动态路由 RAG 的本质就是先做意图判断,再决定是否走 RAG 检索,而不是无脑全量检索。传统RAG是单向的流水线,无论问题简单复杂都要去查知识库
动态路由RAG相比传统RAG区别
| 维度 | 传统 RAG | 动态路由 RAG |
|---|---|---|
| 检索方式 | 静态全量 | 动态定向 |
| 复杂问题支持 | 差 | 极强 |
| 准确率 | 中低 | 高 |
| 效率 | 低 | 高 |
| 幻觉 | 易出现 | 显著减少 |
| 扩展性 | 差 | 极强 |
| 成本 | 高 | 低 |
Chroma向量库
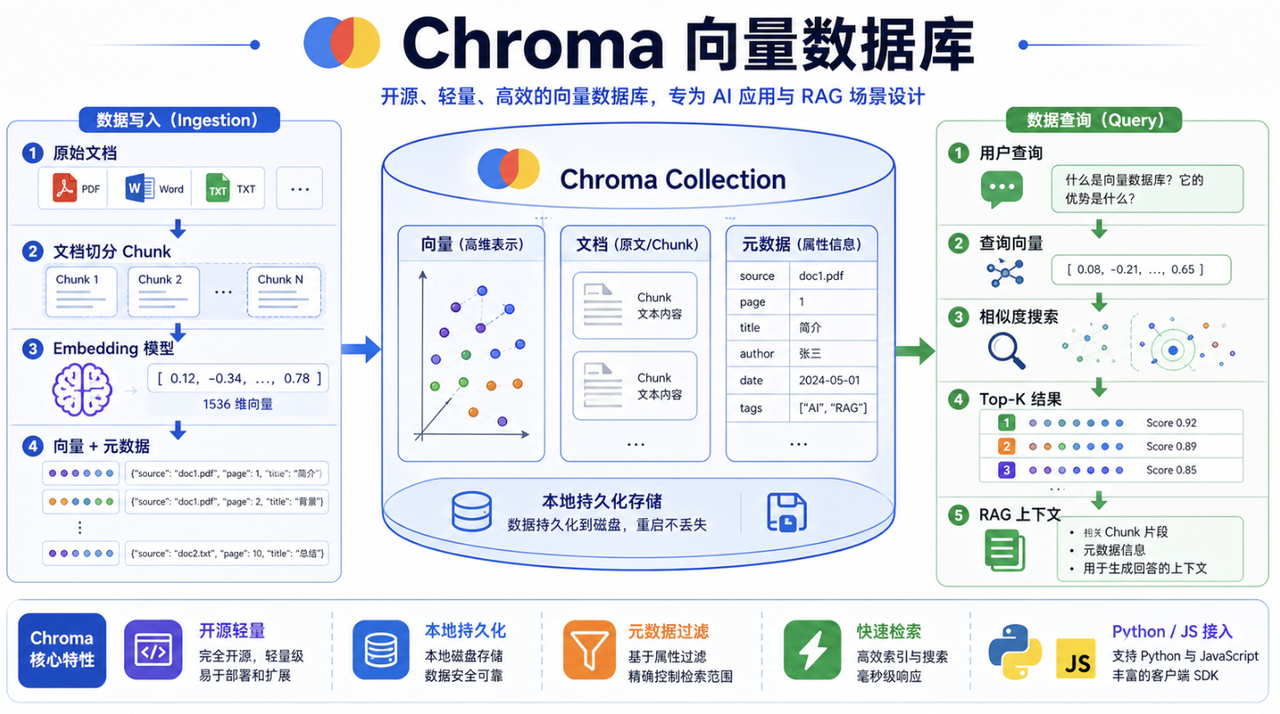
[!NOTE] 一个开源的嵌入式向量数据库。在 RAG 流程中,需要将文本转换成向量并存储起来以便检索,向量库还有 Milvus、Pinecone 或 PostgreSQL 的 pgvector 插件。
向量数据库(有基础的可以直接跳过)
Vector Database
向量数据库Vector Database是一种专门用于存储、索引、检索高维向量数据的数据库。区别于传统关系型数据库MySQL、PostgreSQL、文档型数据库MongoDB、搜索引擎Elasticsearch,其设计初衷就是解决高维向量的高效相似度匹配问题,而非传统数据的结构化查询。
区别
这里用表格展示一下向量数据库与传统数据库、搜索引擎的区别
| 对比维度 | 向量数据库 | 传统关系型数据库(MySQL) | 搜索引擎(Elasticsearch) |
|---|---|---|---|
| 核心存储对象 | 高维向量Embedding+ 元数据 | 结构化数据,表、行、列 | 文本、日志等半结构化数据,倒排索引 |
| 核心检索方式 | 向量相似度匹配 | SQL 结构化查询 | 关键词匹配、模糊匹配 |
| 高维数据支持 | 原生支持,优化高维检索性能 | 不支持,存储向量需拆分为多列,无法高效检索 | 通过插件支持,但检索精度、速度远低于向量数据库 |
| 适用场景 | 大模型 RAG、语义检索、推荐系统、图像识别 | 业务数据存储、交易系统、结构化报表 | 日志检索、关键词搜索、全文检索 |
| 检索延迟(亿级数据) | 毫秒级 | 无法实现高效检索 | 百毫秒级,且语义匹配精度低 |
总结一下就是,ES 可以做简单的向量检索,但无法支撑大规模、高精度的 RAG 场景。MySQL 完全不适合向量检索,仅能作为辅助存储结构化元数据。向量数据库是大模型 RAG 架构中,检索层的唯一最优选择。
Embedding
向量Embedding是将非结构化数据文本、图片映射到高维空间中的数值表示,每一个向量都是一个固定长度的数组,常见的有768 维、1024 维,数组中的每一个浮点数都对应原始数据的一个语义特征。
举个🌰,文本“我想买一部苹果手机”,通过 Embedding 模型转化为 768 维向量后,数组中的每一个数值,分别对应“购买”“苹果”“手机”等语义特征的强度,语义越相关的文本,向量在高维空间中的距离越近。
Embedding模型
| 模型类型 | 代表模型 | 向量维度 | 优势 | 适用场景 |
|---|---|---|---|---|
| 开源通用模型 | BGE-base、BGE-large、M3E-base | 768 维(base)、1024 维(large) | 免费、开源、可本地部署、语义精度高 | 企业级 RAG、私有部署场景 |
| 开源轻量模型 | all-MiniLM-L6-v2、paraphrase-MiniLM-L6-v2 | 384 维 | 速度快、内存占用低、部署简单 | 开发测试、小体量知识库 |
| 闭源商用模型 | OpenAI text-embedding-3-small/large、阿里云通义 Embedding | 512 维(small)、1536 维(large) | 语义精度极高、适配多语言、无需本地部署 | 对检索精度要求高、不想维护本地模型的场景 |
| 领域专用模型 | 医疗 Embedding、法律 Embedding、代码 Embedding | 768-1024 维 | 适配特定领域语义 | 医疗、法律、金融等垂直领域 RAG |
相似度计算
向量数据库的核心操作就是相似度计算,通过计算查询向量与库中所有向量的距离,排序后返回 Top-K 最相似的向量
余弦相似度Cosine Similarity
计算两个向量之间的夹角余弦值,取值范围为 [-1, 1],值越接近 1,说明两个向量方向越一致语义越相似,值越接近 -1,说明方向相反。值为 0,说明两个向量无关。
只关注向量方向,不关注向量长度,不受向量归一化影响,是大模型 RAG 文本检索场景中最常用的计算方式
欧氏距离Euclidean Distance
计算两个向量在高维空间中直线距离,距离越小,说明两个向量越相似,取值范围为 [0, +∞)。
同时关注向量方向和长度,对向量的归一化敏感,若向量未归一化,长度差异会影响距离计算结果,计算成本略高于余弦相似度。
Dot Product点积
计算两个向量的点积,对应维度数值相乘后求和,点积越大,说明两个向量越相似,取值范围为 (-∞, +∞)。
计算速度最快,当向量经过 L2 归一化后,点积结果等价于余弦相似度,此时可替代余弦相似度,提升检索速度。
三种计算方式对比
[!NOTE] - RAG 文本检索:优先选择余弦相似度,语义匹配精度最高。 - 高并发 RAG 场景:向量归一化后,选择点积,提升检索速度。 - 非文本场景,图像、视频:选择欧氏距离,贴合特征匹配需求。
向量索引
向量数据库之所以能实现毫秒级检索,核心在于向量索引,如果没有索引,向量数据库会暴力遍历所有向量,检索延迟会随数据量呈线性增长。而索引的本质,则是通过预处理,构建高维空间的检索结构,减少检索时的计算量。
HNSW
Hierarchical Navigable Small Worlds,工业界 RAG 场景的默认选择,几乎所有主流向量数据库Milvus、Qdrant、Weaviate都优先支持,平衡了检索精度和检索速度。
HNSW原理是构建多层级的导航图,底层是所有向量构成的图结构,上层是底层向量的抽样导航节点,检索时,从最上层导航节点开始,快速定位到相近的节点,逐步下探到底层,找到最相似的向量,避免暴力遍历。
IVF倒排文件索引
将高维空间划分为多个聚类簇,通过 K-Means 算法,每个簇对应一个倒排表,存储该簇内的所有向量。检索时,先找到与查询向量最接近的几个簇,再在这些簇内遍历向量,计算相似度。
PQ乘积量化
将高维向量拆分为多个低维子向量,对每个子向量进行量化,将连续值映射为离散值。通过存储量化后的离散值,大幅降低存储成本和计算成本,检索时通过量化后的子向量计算相似度实现快速匹配。
SCANN
Google 开源的索引算法,平衡精度和速度,适合大规模数据,支持混合检索。
FAISS 索引
Facebook 开源的向量检索库,包含 IVF、PQ 等多种索引,适合原型验证、学术研究,不适合生产环境
索引总结
关于哪些场景最适合那种索引方法
- PoC 测试、小体量知识库,百万级以内:HNSW。
- 企业级生产、中大规模,百万-亿级:HNSW。
- 超大规模十亿级以上:IVF + PQ 组合,优先控制存储和速度,牺牲部分精度。
- 原型验证、学术研究:FAISS 索引,快速搭建,不适合生产。
Flux
[!NOTE] 1. Facebook 提出的一种前端单向数据流架构,利用前端单向数据流架构来优雅地处理后端通过 SSE 持续推送的大模型生成内容。是实现了流式数据的接收与 UI 渲染解耦。 1. 复杂的多模型、多会话场景下状态清晰可控,用户体验上也实现流畅的打字机效果。
三、⚾️业务背景
为什么要做心理场景的Agent呢?大家可以这样回答:
我选择做心理场景的 Agent,是因为心理支持存在一个很明显的供需错配:很多人在压力、焦虑或者情绪低落时需要即时帮助,但专业服务不一定随时可得,而且求助本身也有心理门槛。
这个场景又比较适合 Agent。用户通常不是只需要一次问答,而是需要持续倾听、记录情绪变化、理解长期背景,并在合适的时候提供提醒、练习或行动建议。相比普通聊天机器人,Agent 可以围绕一个长期目标持续跟进,形成“理解—干预—反馈—调整”的闭环。
我们的定位不是让 AI 替代心理咨询师,更不是做诊断,而是提供低门槛的日常心理支持,例如情绪梳理、心理教育、习惯练习和风险识别。当发现自伤等高风险信号时,系统应该停止常规对话,引导用户联系专业机构或紧急支持。
[!NOTE] 当然,大家也可以包装为别的场景,这些都完全可以。后续我也会给大家多出几个这个项目的包装场景,并在文档里更新包装好的场景和简历写法
四、🐧项目流程
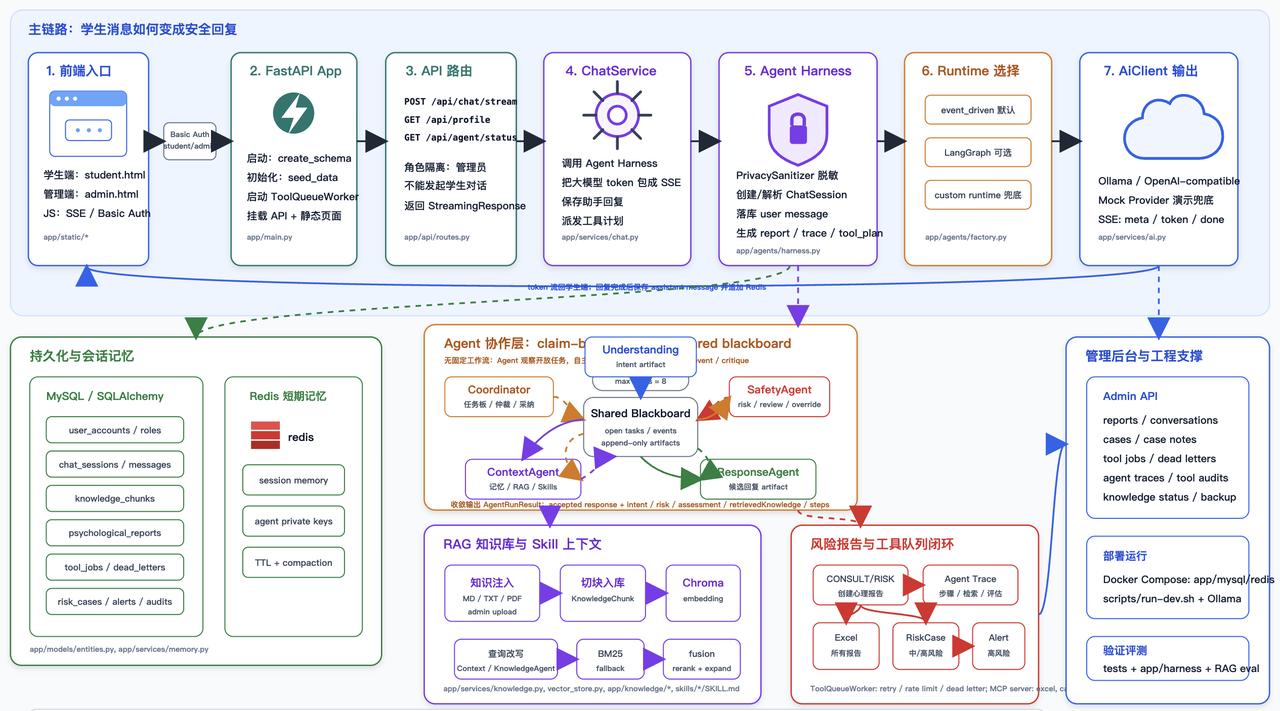
1. 学生端对话流程
浏览器 / 前端
-> Basic Auth
-> POST /api/chat/stream
-> ChatService.stream_chat
-> MindBridgeAgentHarness.run
-> -> trim + 脱敏
-> 解析/创建 session
-> create_agent_runtime(...).run(...)
-> 保存学生消息
-> 生成报告/trace/tool plan
-> AiClient 流式调用 AI provider
-> SSE token 返回前端
-> 保存助手消息
-> ToolQueueService 或 MCP client 处理后续工具任务
HTTP 层非常薄,核心业务编排放在 MindBridgeAgentHarness
2. Agent 动态路由流程
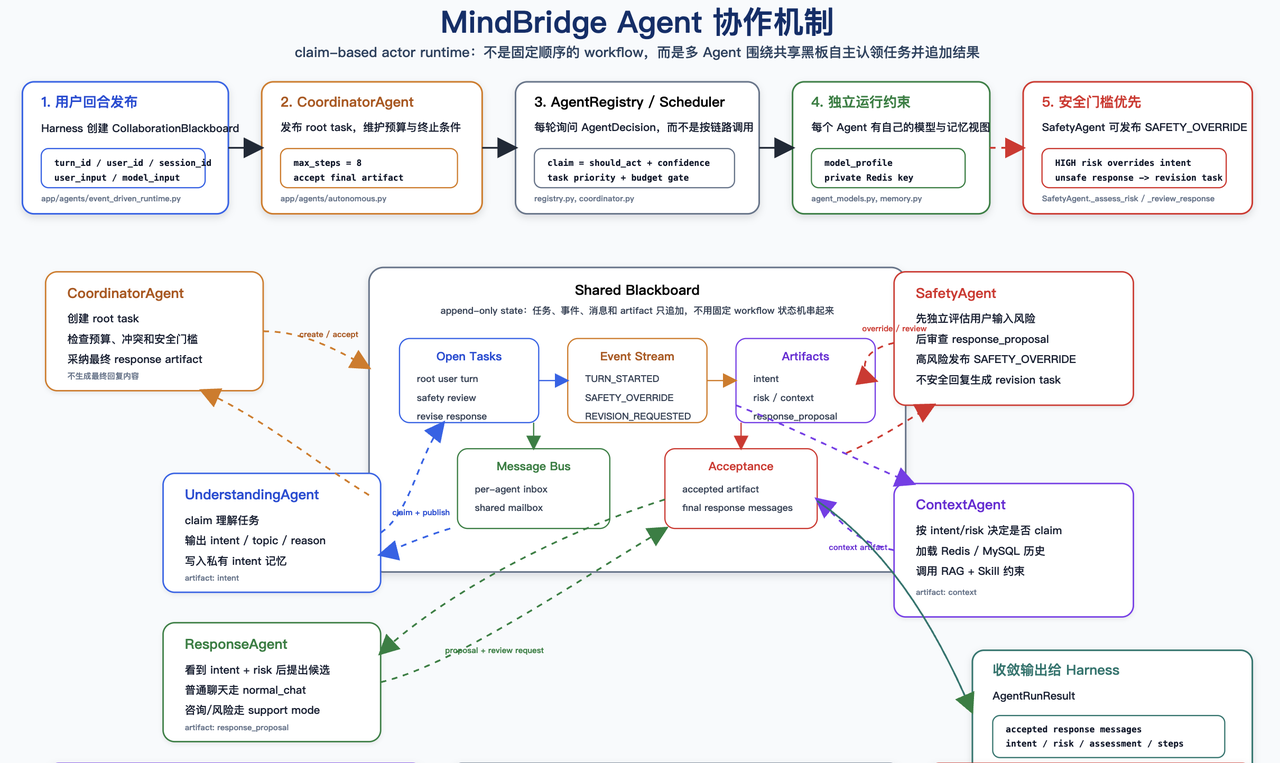
CoordinatorAgent -> UnderstandingAgent / SafetyAgent / ContextAgent / ResponseAgent,通过任务板和 artifact 协作,不是固定链式顺序。
CoordinatorAgent 创建任务板
-> UnderstandingAgent 产出 intent artifact
-> SafetyAgent 产出 risk artifact,可发布 SAFETY_OVERRIDE
-> ContextAgent 在 CONSULT/RISK 或中高风险时补充记忆、RAG、skill 上下文
-> ResponseAgent 产出候选回复 prompt
-> SafetyAgent 审查候选回复
-> CoordinatorAgent 最终采纳
根据黑板上的 artifact 缺什么,就创建什么任务,Agent 自己 claim task。
五、技术栈
Python
这个项目整体是用 Python 写的,后端接口、Agent 编排、RAG 检索、工具调用、后台任务这些核心逻辑都在 Python 里实现。
FastAPI
FastAPI 主要用来搭后端服务,提供学生聊天接口、管理员后台接口、知识库上传接口、健康检查接口等。聊天接口用了流式返回,让前端能一点点显示模型回复
Harness Engineering
Agent 外面设计了一层 Harness,不是直接让 Agent 跑。Harness 负责把一次用户请求完整包起来,比如输入脱敏、会话创建、上下文加载、Agent 执行、心理报告生成、工具计划生成和后续工具调度。这样 Agent 逻辑和业务流程不会混在一起。
Skill
Skill 是把一些固定能力封装起来,比如高风险安全计划、辅导员交接摘要这些。这样 Agent 遇到特定场景时,可以复用这些能力,而不是每次都靠 prompt 临时生成。
Docker
Docker 用来做容器化部署。项目提供了 Dockerfile 和 docker-compose,可以一起启动 FastAPI 应用、MySQL、Redis,方便本地演示和交付部署。
LoRA
LoRA 用来做大模型的轻量微调。它的好处是不用全量训练大模型,只训练少量适配参数,让模型更贴近校园心理健康场景,成本和部署压力都更低。
SQLAlchemy
SQLAlchemy 是项目里的 ORM,用来操作数据库。用户、会话、聊天消息、心理报告、风险个案、工具任务、预警记录这些数据表,都是通过 SQLAlchemy 模型来管理的。
Basic Auth
Basic Auth 用来做基础认证。项目里区分学生账号和管理员账号,学生可以聊天,管理员可以查看报告、风险个案和预警记录。
Ollama
Ollama 用来在本地运行大模型。项目可以接入本地微调后的 Qwen 模型,这样比较适合私有化部署,也能减少对外部云模型的依赖。
MySQL
MySQL 是主业务数据库,用来保存完整的数据,比如用户信息、聊天记录、心理评估报告、风险个案、后台预警记录等。Redis 只保存短期上下文,真正长期、完整的数据还是落在 MySQL。
Redis
Redis 用来做短期记忆。每个会话最近几轮聊天会存在 Redis 里,Agent 回复时可以快速拿到上下文。如果 Redis 没有数据,还可以从 MySQL 回填一部分历史记录。
Chroma
Chroma 是向量数据库,用来支撑 RAG。项目会把校园心理知识库切块后写入 Chroma,用户提问时先做语义检索,再把相关知识交给模型生成回答。
MCP
MCP 用来做工具调用。项目把写 Excel 风险台账、创建风险个案、发送预警、确认个案这些能力暴露成 MCP 工具,Agent 或后端流程可以按需调用。
六、多agent协作
[!NOTE] 首先介绍一下什么是多agent协作
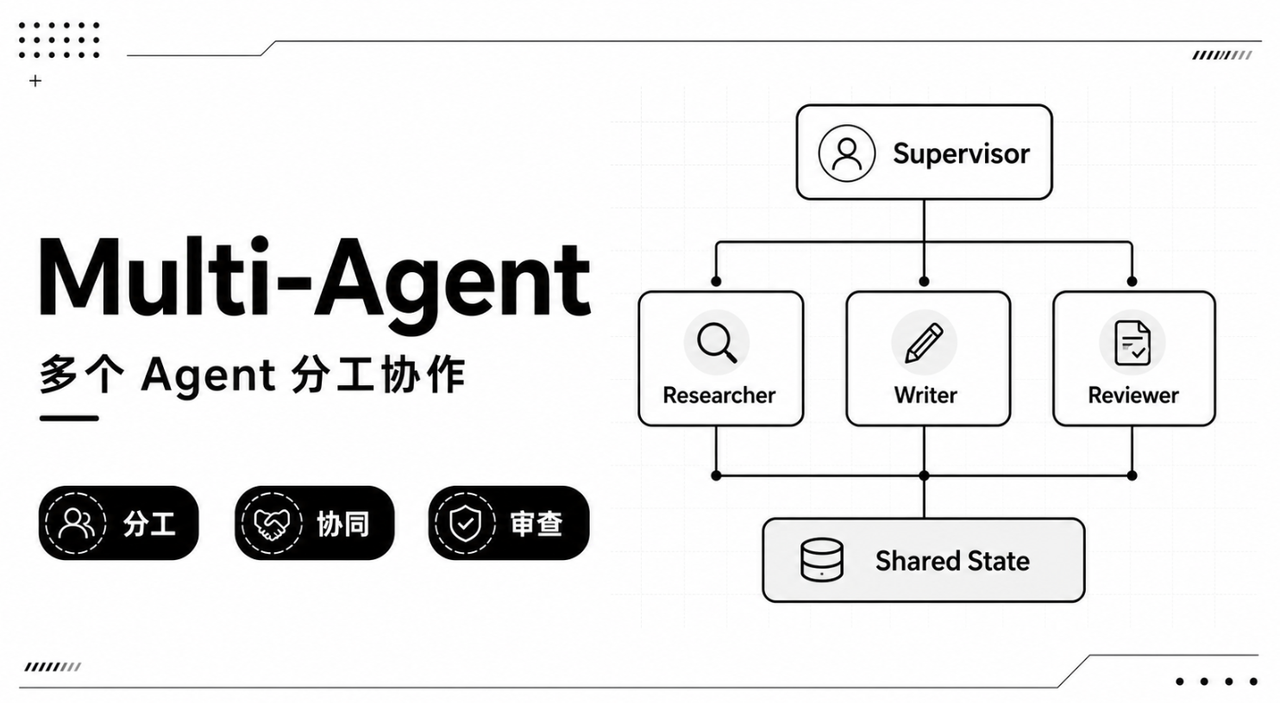
Multi-Agent 是把一个大任务拆给多个角色,比如 Planner、Researcher、Coder、Reviewer。
典型流程:
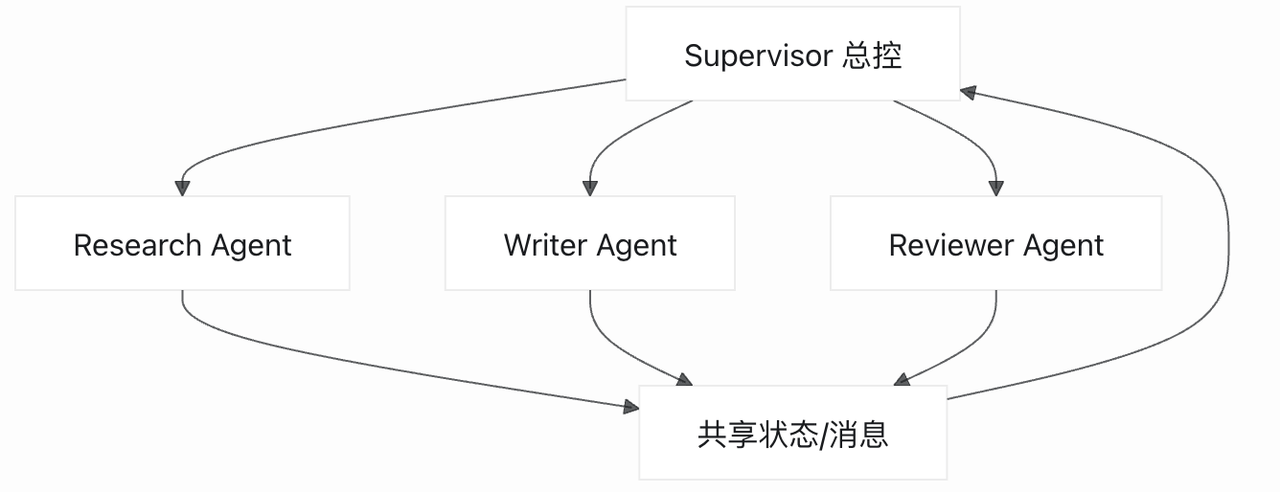
举个🌰: 一篇行业报告,Research Agent 负责搜资料,Analyst Agent 负责分析,Writer Agent 负责写作,Reviewer Agent 负责挑错。
[!NOTE] 为什么要设计多agent协作
这样设计不是为了堆概念。校园心理健康场景里,一句话可能有很多含义。学生说 "我睡不着",可能只是作息问题,也可能和焦虑、考试、关系冲突有关。学生说 "我不想活了",系统必须优先处理安全风险。学生问 "Python 字典推导式怎么写",它又不应该被硬拽进心理咨询流程。单一 prompt 很难同时兼顾这些情况。MindBridge 用多 Agent 协作把职责拆开,让理解、风险、上下文、回复和后处理各自有位置。
当前项目默认使用 event_driven_multi_agent。这是一个事件驱动的多 Agent runtime,系统会创建共享任务板,让 Agent 根据自己的能力声明是否接手任务,再由协调器控制轮次、预算、安全审查和最终采纳。
一句话进入系统以后发生了什么
学生端通过 SSE 聊天接口提交消息。HTTP 层主要负责认证、参数处理和流式输出,真正的一轮 Agent run 由 MindBridgeAgentHarness 组织。Harness 先解析或创建会话,再用 PrivacySanitizer 对手机号、邮箱、身份证号等敏感信息脱敏,随后调用 create_agent_runtime 选择当前可用的 Agent runtime。
runtime 执行完成后,Harness 会做几件后置工作。
它会保存学生消息,按 Agent run 结果决定是否创建心理报告,把 agent steps、协作事件、任务、artifact、检索知识和评估 JSON 写入 AgentRunTrace,然后生成工具计划。如果本轮需要后台动作,比如写 Excel 台账、创建风险个案或发送高风险预警,这些动作不会卡住学生端回复,而是进入 ToolQueueService。
这条链路的价值很实在。学生看到的是一个连续的聊天体验,管理员看到的是可追溯的后台记录,开发者看到的是每个 Agent 的动作、输入、输出和采纳理由。心理健康类系统最怕只有一句 "模型是这么回答的"。MindBridge 能回答几个更具体的问题:谁判断了意图,谁判断了风险,系统检索了哪些知识,候选回复有没有经过安全审查,最终为什么被采纳。
事件驱动多 Agent
当前默认 runtime 的核心对象是 CollaborationBlackboard,可以理解为一轮对话的共享任务板。它保存用户输入、脱敏输入、任务列表、Agent 消息、产物 artifact、事件 event 和最终采纳的 artifact id。这个黑板不是让 Agent 随便改同一份状态,而是通过追加任务、追加事件、发布 artifact 的方式留下轨迹。
[!NOTE] 黑板上有四类内容最关键
-
第一类是 task。
task 表示待处理工作,比如 "Understand user turn"、"Assess safety risk"、"Gather contextual evidence"、"Propose candidate response"、"Review candidate response safety"。每个 task 有优先级、状态、所需能力和创建者。高风险场景下,安全和回复任务会被提升到 CRITICAL。
-
第二类是 event。
event 记录协作过程,比如 TURN_STARTED、TASK_CREATED、TASK_CLAIMED、ARTIFACT_PUBLISHED、REVISION_REQUESTED、SAFETY_OVERRIDE、FINAL_ACCEPTED。这些事件最后会转成 trace,管理员和开发者可以从后台看到一轮对话的完整经过。
-
第三类是 artifact。
artifact 是 Agent 交付出来的结构化结果。UnderstandingAgent 发布 intent,SafetyAgent 发布 risk 和 safety_review,ContextAgent 发布 context,ResponseAgent 发布 response_proposal。最终回复不是某个 Agent 单方面说了算,而是一个经过 SafetyAgent 审查、置信度达到阈值、由 CoordinatorAgent 接受的 response_proposal。
-
第四类是 message。
message 是 Agent 之间的协作通知。比如 ContextAgent 会告诉 ResponseAgent 上下文已经准备好,ResponseAgent 会请求 SafetyAgent 审查候选回复。它们不是学生端最终消息,而是内部协作通信。
[!NOTE] Agent 不需要按照写死的顺序依次执行,而是看到开放 task 后根据能力和信心决定是否 claim。协调器再按任务优先级、claim 置信度、每轮最多 claim 数和每个 Agent 最多 claim 次数选择执行对象。这样既有自主性,又不会让 Agent 无限互相拉扯。
CoordinatorAgent
CoordinatorAgent 负责把协作收住,不负责理解学生,也不负责写最终回复。它创建 root task,维护任务板,派生缺失工作,控制最大轮次,处理预算耗尽,并决定什么时候可以接受最终回复。
协调器每轮都会检查黑板上还缺什么。如果还没有 intent,它创建理解任务。如果还没有 risk,它创建安全评估任务。如果 intent 是 CONSULT 或 RISK,或者风险已经到 MEDIUM、HIGH,它会创建上下文收集任务。如果 intent、risk 和必要上下文已经具备,它会创建候选回复任务。候选回复出来后,它还会创建安全审查任务。
[!NOTE] 最终采纳也有门槛。黑板上必须有 response_proposal,也必须有对应的 safety_review。SafetyAgent 需要明确批准,候选回复的 confidence 还要高于 agent_final_acceptance_min_confidence,默认是 0.6。满足这些条件以后,CoordinatorAgent 才会记录 FINAL_ACCEPTED。
这个机制让多 Agent 不会变成 "大家都说两句"。Agent 可以独立 claim 任务,但最终出口只有一个。高风险场景里,SafetyAgent 还能发布 SAFETY_OVERRIDE,把本轮风险抬到 HIGH,后续上下文、回复和工具队列都会按高风险处理。
UnderstandingAgent
UnderstandingAgent 只做理解,不做安慰,也不做风险处置。
它会判断本轮输入属于 CHAT、CONSULT 还是 RISK,并给出主题和理由。普通学习、编程、校园事务、作业、翻译、总结等问题会倾向于 CHAT。压力、焦虑、低落、失眠、关系冲突等会倾向于 CONSULT。自杀、自残、轻生、伤害自己等明确表达会优先进入 RISK。
它的判断不是完全依赖模型。项目里有本地规则函数,比如 has_high_risk_signal 和 has_consult_signal。高风险信号命中时,系统直接走风险意图。普通任务词命中且没有咨询信号时,系统会倾向普通聊天。只有需要细分时才调用模型做 intent 判断。模型失败时,本地规则仍然能给出保守结果。
SafetyAgent
[!NOTE] SafetyAgent 有两份工作。第一份是评估学生输入的风险。第二份是审查 ResponseAgent 给出的候选回复能不能发给学生。
风险评估由 PsychologicalAssessmentService 完成。它会结合当前输入和上下文,输出结构化结果,包括 risk、emotion、emotionScore、confidence 和 summary。高风险硬规则仍然优先。只要识别到明确自伤、自杀或即时危险信号,SafetyAgent 会发布 SAFETY_OVERRIDE。这个事件比普通 artifact 更强,后续选择 risk 时会直接把本轮视为高风险。
ResponseAgent 先提出候选回复 prompt,SafetyAgent 再检查它是否满足当前风险约束。高风险场景下,如果候选回复缺少 "当前安全"、"可信任的人"、"紧急" 等即时安全指引,SafetyAgent 会拒绝批准,发布 critique,并创建 revision task 让 ResponseAgent 重写。也就是说,系统不是生成一次就结束,它给安全审查留了返工通道。
学生端不会看到 risk level、emotion score 或后台 summary。SafetyAgent 的结果主要给报告、trace、工具队列和管理员使用。这个隔离很重要。后台需要结构化风险判断,学生端需要的是谨慎、具体、非评判的支持话语。这两种语言不应该混在一起。
ContextAgent
ContextAgent 不写最终回复,也不判断候选回复能不能发。它负责准备本轮回复需要的证据和约束。
- [ ] 它先读取短期记忆。项目使用 Redis 保存最近对话,默认有过期时间和最大消息数。如果 Redis 里没有,它会从 MySQL 的完整聊天记录回填,再写回 Redis。进入模型前,历史会经过 compact_history_for_prompt 压缩,保留最近上下文和简短摘要。ContextAgent 还会尝试用自己的模型客户端生成 1 到 3 条中文记忆要点,并明确要求不输出风险等级或诊断。
- [ ] 在 CHAT 且低风险的场景里,ContextAgent 通常不需要做 RAG。学生问代码、作业解释、校园事务时,系统不强行检索心理知识库。只有进入 CONSULT、RISK,或风险到中高等级时,它才会改写查询词,调用 KnowledgeService 检索知识库。
[!NOTE] RAG 不是单一路径。系统优先用 Chroma 做向量召回,同时用 BM25 做关键词召回,再按配置权重融合、本地 rerank,并扩展相邻 chunk。向量服务不可用、没有 OpenAI API key 或 Chroma 异常时,系统会回退到本地 BM25 和词面 rerank。这个设计很适合演示和私有化交付,因为现场环境不稳定时,心理支持链路仍然可以继续工作。
ContextAgent 还会加载 MindBridge 的标准 Skill。一般咨询会加载基础支持和转介资源。焦虑、惊恐、呼吸相关输入会加载 grounding 指引。失眠、熬夜、睡眠相关输入会加载睡眠作息支持。考试、绩点、论文、作业、学业压力会加载学业压力规划。高风险时只加载基础支持和高风险安全计划,避免把注意力分散到太多建议上。
ResponseAgent
[!NOTE] ResponseAgent 是学生端回复的规划者。它不会绕过安全审查直接成为最终答案,而是根据黑板上的 intent、risk、context、skill 约束和用户历史,提出一个 response_proposal。
- 普通聊天走 normal chat mode。此时它主要使用通用回答 prompt,结合会话历史自然回答问题。学生问 Python、数据库、作业思路、校园事务时,系统不会突然开始心理测评,也不会输出后台风险语言。
- 心理支持和风险场景走 support mode。此时 ResponseAgent 会拿到记忆摘要、RAG 证据、Skill 约束和风险等级,再生成候选回复 prompt。低中风险场景下,回复会先承接学生情绪,再给出少量可执行步骤,比如稳定呼吸、拆任务、降低睡前刺激、联系校内心理资源。高风险场景下,它要优先处理当前安全,引导学生联系身边可信任的人、学校心理中心、辅导员或当地紧急救助。
ResponseAgent 的设计重点不是 "说得像心理咨询师",而是知道边界。它不能诊断疾病,不能开药,不能替代持证心理咨询师,不能把后台标签直接说给学生,也不能提供危险操作细节。候选回复生成后,还要交给 SafetyAgent 审查。只有审查通过并被 CoordinatorAgent 采纳,才会进入真正的学生端生成。
Agent 之间怎么协作
[!NOTE] UnderstandingAgent 给出 intent,SafetyAgent 给出 risk,ContextAgent 给出记忆、知识和 Skill,ResponseAgent 给出候选回复,SafetyAgent 再审一次,CoordinatorAgent 最终采纳。
举个🌰。学生说 "帮我解释一下 Python list comprehension"。UnderstandingAgent 判断为 CHAT,SafetyAgent 评估为低风险。CoordinatorAgent 发现不需要上下文证据,就创建回复任务。ResponseAgent 用 normal chat mode 提出回答方案,SafetyAgent 审查通过,CoordinatorAgent 接受最终回复。整条链路比较短,学生不会收到不必要的心理支持话术。
再看咨询场景。学生说 "我最近压力很大,睡不着,明天还有考试"。UnderstandingAgent 会倾向 CONSULT。SafetyAgent 做风险评估,如果没有自伤表达,大概率是低到中风险。ContextAgent 读取记忆,检索睡眠、考试季、学业压力相关知识,并加载 sleep routine 和 academic stress 相关 Skill。ResponseAgent 根据这些材料提出支持性回复。SafetyAgent 审查候选回复是否越界,CoordinatorAgent 采纳后再输出给学生。
高风险场景更严格。学生说 "我不想活了" 或类似表达时,本地高风险信号会先命中。SafetyAgent 发布 SAFETY_OVERRIDE,CoordinatorAgent 会把安全、上下文、回复、审查任务都提到更高优先级。ResponseAgent 的候选回复必须围绕当前安全和现实求助。SafetyAgent 如果认为回复缺少即时安全指引,会要求重写。最终报告进入工具队列,后续会创建风险个案并触发预警。
所以,多 Agent 带来的不是更多话术,而是不同场景走不同路径。普通聊天不用扛心理咨询的全部成本,咨询场景能用记忆和知识库,高风险场景则有更硬的安全门槛。
私有记忆让 Agent 不互相污染
[!NOTE] 除了会话级短期记忆,事件驱动版本还引入了 AgentPrivateMemory。每个 Agent 有自己的 Redis key,格式类似 agent:SafetyAgent:
。UnderstandingAgent 记录自己最近的 intent 判断,SafetyAgent 记录风险判断和审查结果,ContextAgent 记录本轮检索和上下文准备情况,ResponseAgent 记录回复模式和策略。
这不是给学生建长期画像,而是给 Agent 保留有限的工作记忆。它有两个好处。
第一,Agent 不需要每轮从零开始理解自己的上一次判断。
第二,不同 Agent 的内部记录不会混在一起。SafetyAgent 的风险记录不会直接塞给 ResponseAgent 当学生端语言,ResponseAgent 的表达策略也不会污染 UnderstandingAgent 的意图判断。
心理健康场景里,记忆要克制。系统需要记住足够多的上下文来避免 "每次都像第一次见面",也要避免把隐私和后台标签无限扩散。MindBridge 把记忆拆成会话短期记忆、压缩摘要、Agent 私有记忆和数据库完整记录,分别服务不同用途。
每个 Agent 可以使用不同模型
[!NOTE] AgentModelRegistry 允许不同 Agent 使用不同 provider、model、temperature 和 max tokens。
默认情况下,它们会继承全局 AI 配置,比如 Ollama 本地模型或 OpenAI-compatible 云端模型。需要时,可以给 UnderstandingAgent、SafetyAgent、ContextAgent、ResponseAgent 等单独配置模型。
这个能力很实际,意图判断不一定需要大模型,风险评估可能更需要稳定和保守,回复生成则更依赖表达质量。把模型配置拆到 Agent 级别后,项目以后可以用小模型做分类,用更稳的模型做风险,用另一个模型做最终语言生成,而不必改整个系统的主配置。
RAG 在多 Agent 里的位置
MindBridge 的知识库覆盖校园心理支持总则、风险等级策略、焦虑和惊恐、低落情绪、睡眠作息、学业压力、考试季、人际关系、新生适应、咨询转介和隐私边界。它不是给普通聊天凑内容,而是给心理支持场景提供依据。
ContextAgent 只有在需要时才触发检索。它会先把当前输入和记忆摘要改写成查询词,再调用 KnowledgeService。KnowledgeService 会从数据库分块、Chroma 向量库、BM25 关键词召回和本地 rerank 里组织候选内容。最后进入 ResponseAgent 的不是整个知识库,而是少量和本轮相关的片段。
这样做比把所有心理知识都写进 prompt 更可维护。学校更新咨询中心地址、危机热线、转介流程或校园政策时,可以改知识库和 Skill,不必重写 Agent。trace 里也能看到本轮检索 query 和命中的知识来源,便于复盘回复是不是有依据。
trace
AgentTraceService 会把一轮 Agent run 保存成 trace。它不只保存最终回复,还保存 intent、risk、原始输入、脱敏输入、memory brief、agent steps、retrieved knowledge、response messages、assessment JSON,以及事件驱动版本里的 collaboration events、tasks 和 artifacts。
这对调试很有用,普通聊天被误判成咨询时,可以看 UnderstandingAgent 的 intent artifact。知识库没有命中时,可以看 ContextAgent 的 query 和 retrievedKnowledge。高风险回复没有触发预警时,可以看 SafetyAgent 有没有发布 high risk artifact,工具计划有没有生成,ToolQueue 有没有入队。候选回复被拒绝时,可以看到 critique 和 revision task。
为什么不用一个 Agent 全部做完
单 Agent 当然更简单,一个 prompt、一次模型调用、几段后处理代码,项目很快就能跑起来。小型问答或普通陪聊可以这么做。MindBridge 没有这么做,是因为它的职责不止 "答一句话"。
[!NOTE] 第一,单 Agent 的 prompt 会越来越大。
它要同时处理意图判断、风险识别、记忆压缩、RAG query 改写、知识引用、学生端回复、安全边界、后台摘要和工具触发。功能越多,prompt 越像一份混乱的操作手册。模型表面上都看到了,实际执行时很容易漏掉某一条。
[!NOTE] 第二,单 Agent 容易混淆学生端语言和后台语言。
risk level、emotion score、confidence、summary 这些字段对管理员有用,但不该直接说给学生。MindBridge 把风险评估、回复生成、人工交接拆开,能减少后台标签泄漏到学生端的机会。
[!NOTE] 第三,高风险不能只靠模型自觉。
项目里有本地高风险规则、SafetyAgent 风险 artifact、SAFETY_OVERRIDE、候选回复安全审查、工具队列预警和 dead letter。它们分布在不同层,不会因为某一次语言生成失误就全部失效。
[!NOTE] 第四,单 Agent 会浪费资源,且单agent不好测试
普通问题不需要 RAG,不需要加载心理 Skill,也不需要生成风险报告。多 Agent 路由后,CHAT 可以走短链路,CONSULT 和 RISK 才使用更重的上下文、检索和安全审查。这个仓库已经有事件驱动协议测试、registry 排序测试、coordinator claim 测试、Agent model override 测试,还有风险、安全、Skill、记忆压缩、工具治理等测试。多 Agent 拆开后,测试能检查中间决策,而不只是看最后一句回复像不像。
[!NOTE] MindBridge 的多 Agent 协作不是为了让系统看起来更复杂,而是为了把校园心理健康场景里的几类责任拆清楚。理解归理解,风险归风险,上下文归上下文,回复归回复,安全审查归安全审查,后台闭环归后台闭环。每一轮对话都有任务、事件、artifact 和 trace,可以被解释,也可以被复盘。
这套架构最大的好处,是让系统在同一个学生入口里处理不同强度的问题。普通聊天不必走重流程,心理咨询能利用知识库和 Skill,高风险表达有更硬的安全通道。模型仍然参与核心判断和语言生成,但它不是唯一的安全网。对校园心理健康这种需要谨慎、留痕和人工接手的场景来说,这种受控的多 Agent 协作比单 Agent 更合适。
七、agent runtime
事件驱动
当前代码里的 runtime 入口是 app/agents/factory.py:
def create_agent_runtime(db: Session, settings: Settings) -> EventDrivenAgentRuntimeService:
    from app.agents.event_driven_runtime import EventDrivenAgentRuntimeService

    return EventDrivenAgentRuntimeService(db, settings)
默认配置在 app/core/config.py:
agent_framework = event_driven_multi_agent
agent_max_rounds = 8
agent_max_claims_per_round = 4
agent_max_claims_per_agent = 3
agent_final_acceptance_min_confidence = 0.6
这几个值决定了 runtime 的边界。它不是无限循环。Coordinator 最多跑 8 轮,每轮最多选择 4 个 claim,同一个 Agent 最多 claim 3 次。候选回复的 confidence 低于 0.6,即使 SafetyAgent 审查通过,也不会被最终采纳。
一轮请求从哪里进入 runtime
学生端请求进入 POST /api/chat/stream。路由在 app/api/routes.py,管理员账号不能发起学生对话,学生账号通过以后,路由创建 ChatService,然后返回 SSE 流式响应。
实际流程是这样的:
POST /api/chat/stream
-> ChatService.stream_chat()
-> MindBridgeAgentHarness.run()
-> create_agent_runtime(...).run()
-> EventDrivenCoordinator.run(board)
-> AgentRunResult
-> AiClient.stream(response_messages)
-> SSE token
-> 保存助手消息
-> 派发工具计划
-> SSE done
ChatService 不负责判断意图,也不负责创建心理报告,更不直接写 Excel 或发预警。它主要做三件事:调用 harness,拿到 runtime 准备好的 response_messages,再用 AiClient.stream() 把最终文本逐 token 发给前端。
真正的一轮业务闭环在 MindBridgeAgentHarness。它做输入脱敏、会话解析、调用 runtime、保存用户消息、生成心理报告、写 trace、生成工具计划。这样 HTTP 层很薄,runtime 也不用关心数据库里报告怎么建、工具任务怎么派发。
Harness 和 runtime 的边界
MindBridgeAgentHarness 在 app/agents/harness.py。
它先处理输入:
original_input = request.message.strip()
model_input = PrivacySanitizer.sanitize(original_input)
original_input 是学生原文,系统会把它保存进业务数据库,方便后台追溯。model_input 是脱敏后的版本,手机号、邮箱、身份证号会被替换成 [已脱敏]。模型分类、风险评估、摘要、RAG query 改写和回复 prompt 都尽量使用这个脱敏版本。
然后 harness 解析 session。如果请求里带了 sessionId,它会检查这个 session 是否属于当前学生。没有 sessionId 时,它新建一个 ChatSession,public id 用 uuid4().hex,标题取用户输入前 36 个字符。
接下来才调用 agent runtime:
agent_run = create_agent_runtime(self.db, self.settings).run(
    user,
    session,
    original_input,
    model_input,
)
runtime 返回的是 AgentRunResult。它里面有意图、风险等级、心理评估、检索知识、回复 messages、agent steps、记忆摘要,以及黑板协作过程中的 events、tasks、artifacts。
随后 harness 做业务接入:
保存用户消息
-> 如果 intent 不是 CHAT,则创建 PsychologicalReport
-> 保存 AgentRunTrace
-> 生成 AgentToolPlan
-> 返回 AgentHarnessOutcome
注意这个顺序:当前用户消息是在 runtime 执行之后保存的。这样做不影响本轮判断,因为 runtime 已经直接拿到了本轮 original_input 和 model_input。保存消息的作用主要是给下一轮记忆、后台会话记录和审计使用。
runtime 初始化
EventDrivenAgentRuntimeService 在 app/agents/event_driven_runtime.py。它初始化时会创建几类服务:
AiClient
KnowledgeService
RedisShortTermMemoryStore
AgentModelRegistry
AgentPrivateMemory
[!NOTE] 这些服务随后被打包进 AgentRuntimeServices,传给每个 Agent。这样每个 Agent 都可以拿到同一套数据库 session、settings、当前 user、当前 session、模型客户端、知识库、短期记忆和私有记忆入口。
runtime 每轮会创建 5 个 Agent:
CoordinatorAgent
UnderstandingAgent
SafetyAgent
ContextAgent
ResponseAgent
其中 Coordinator 不进入普通 claim 列表,它由 EventDrivenCoordinator 驱动。其他 4 个 Agent 会注册到 AgentRegistry,等待任务出现后判断是否 claim。
这时 runtime 还会创建本轮黑板:
turn_id
user_id
session_id
user_input
model_input
tasks
messages
artifacts
events
final_artifact_id
user_input 保存原始输入,model_input 保存脱敏输入。黑板创建后,runtime 先追加一个 TURN_STARTED 事件,表示本轮学生消息已经发布到共享任务板。
黑板-runtime 的核心状态
黑板定义在 app/agents/events.py,类名是 CollaborationBlackboard。它保存 tasks、messages、artifacts、events 和最终采纳的 artifact id。
这套 runtime 里,Agent 之间不是互相调用对方的方法。它们通过黑板协作。一个 Agent 想做事,先 claim 一个 task。做完以后,它返回 AgentTurnResult,里面可以包含:
messages
artifacts
tasks
events
close_task
黑板再把这些结果合并进去。
比如 UnderstandingAgent 会发布 intent artifact,SafetyAgent 会发布 risk artifact,ContextAgent 会发布 context artifact,ResponseAgent 会发布 response_proposal artifact。SafetyAgent 在审查候选回复后,会发布 safety_review 或 critique。
这几个数据结构的分工很清楚:
AgentTask
表示待做事项,比如理解输入、评估风险、收集上下文、生成候选回复、审查候选回复。

AgentArtifact
表示 Agent 产出的结构化结果,比如 intent、risk、context、response_proposal、safety_review。

AgentMessage
表示 Agent 之间的协作消息,比如 ResponseAgent 请求 SafetyAgent 审查候选回复。

AgentEvent
表示协作过程发生了什么,比如任务创建、任务认领、artifact 发布、安全覆盖、最终采纳。
黑板方法大多返回新对象,不直接改旧对象。测试里也专门验证了这一点:原始 board 不会因为 add task 或 append event 被改掉,artifact 也不会互相覆盖。这让 trace 更可靠。你看到的是一串追加出来的协作记录,而不是一个被不断覆盖的状态对象。
Coordinator 怎么调度
调度逻辑在 app/agents/coordinator.py 的 EventDrivenCoordinator。
每轮开始时,Coordinator 会确保 root task 存在:
task:root
title = Resolve user turn
priority = CRITICAL 或 NORMAL
如果用户输入里已经命中高风险硬信号,比如 "自杀"、"自残"、"不想活"、"结束生命"、"轻生"、"suicide"、"kill myself",root task 会直接变成 CRITICAL。
之后每一轮都按这个节奏跑:
追加 ROUND_STARTED
-> 派生缺失任务
-> 尝试最终采纳
-> 找可认领任务的 Agent
-> Agent claim 并执行
-> 合并 AgentTurnResult
-> 再次派生缺失任务
-> 再次尝试最终采纳
派生任务的逻辑叫 _derive_missing_work()。它会看黑板上缺了哪些 artifact,然后补对应 task。
最开始一般会补两个任务:
task:understand
需要 UNDERSTANDING 能力,产出 intent artifact。

task:assess-safety
需要 SAFETY 能力,产出 risk artifact。
如果 intent 是 CONSULT 或 RISK,或者 risk 已经是 MEDIUM 或 HIGH,Coordinator 会补上下文任务:
task:gather-context
需要 CONTEXT 能力,产出 context artifact。
当 intent 和 risk 都有了,并且上下文已经不需要或已经准备好,Coordinator 会补回复任务:
task:propose-response
需要 RESPONSE 能力,产出 response_proposal artifact。
如果黑板上出现了新的 response_proposal,但还没有对应的安全审查,Coordinator 会补:
task:review-response:<response_id>
需要 SAFETY 能力,产出 safety_review 或 critique。
如果 SafetyAgent 发布了不通过的 critique,Coordinator 会补修订任务:
task:revise-response:<critique_id>
需要 RESPONSE 能力,重新产出候选回复。
最后采纳有硬条件。不是 ResponseAgent 产出候选回复就直接用。Coordinator 只会在这些条件同时成立时调用 accept_final():
有 response_proposal
有 safety_review
safety_review 指向当前最新 response_proposal
safety_review.approved 是 true
response_proposal.confidence >= agent_final_acceptance_min_confidence
默认最小 confidence 是 0.6。当前 ResponseAgent 的候选回复 confidence 是 0.86,SafetyAgent 的审查 confidence 是 0.95。只要审查通过,通常就能被采纳。
claim-based scheduler 怎么选 Agent
AgentRegistry 在 app/agents/registry.py。它做两件事:
先按 task.required_capabilities 过滤 Agent
再调用 Agent.decide(task, board)
如果 Agent 返回 AgentDecision(claim=True, confidence=...),它就进入候选列表。候选列表按 confidence 从高到低排。Coordinator 之后再综合 task priority、decision confidence 和 Agent 名称排序。
[!NOTE] 这一点让 runtime 不是固定链路。它不是写死 "先 Understanding,再 Safety,再 Context,再 Response"。实际顺序由任务和 claim 决定。只是因为一轮对话通常一开始缺 intent 和 risk,所以 UnderstandingAgent 和 SafetyAgent 往往会先工作。到了咨询或风险场景,ContextAgent 才会加入。ResponseAgent 会等 intent 和 risk 至少准备好以后再提候选回复。
调度还有两个限制:
每轮最多选 agent_max_claims_per_round 个 claim,默认 4。
同一个 Agent 每轮只会被选中一次。
同一个 Agent 整个 run 最多 claim agent_max_claims_per_agent 次,默认 3。
这能避免某个 Agent 因为一直认为自己有事可做而占满整个 runtime。
和单 Agent 大 prompt 的区别
单 Agent 大 prompt 的做法通常是把所有规则塞进一个 system prompt:你要判断意图,你要识别风险,你要查知识,你要回复学生,你还要记得别泄露后台标签。短 demo 里这能跑,但一旦要做审计、测试、后台处置,就会很难维护。
MindBridge 把职责拆开以后,很多判断不再埋在 prompt 里:
是否是 CHAT / CONSULT / RISK
由 UnderstandingAgent 产出 intent artifact。

风险等级是什么
由 SafetyAgent 产出 risk artifact,并且有硬规则兜底。

是否需要 RAG 和 skill
由 Coordinator 根据 intent 和 risk 派生 context task。

候选回复是否安全
由 SafetyAgent 对 response_proposal 单独审查。

是否生成报告和工具任务
由 MindBridgeAgentHarness 和 ToolQueueService 根据结构化结果决定。
[!NOTE] 这让每一层都更容易测。tests/test_event_driven_multi_agent.py 已经覆盖了黑板追加、artifact 不覆盖、registry 按 confidence 排序、Coordinator 使用 claim 执行开放任务、AgentModelRegistry 能为不同 Agent 覆盖模型配置。工程 harness 还会跑风险安全、Agent 路由、标准 skills、RAG、API 和工具队列。
普通聊天、咨询和高风险的实际路径
普通聊天一般是这样:
TURN_STARTED
-> task:root
-> task:understand
-> task:assess-safety
-> UnderstandingAgent 发布 intent = CHAT
-> SafetyAgent 发布 risk = LOW
-> task:propose-response
-> ResponseAgent 发布 normal_chat response_proposal
-> task:review-response
-> SafetyAgent 发布 safety_review approved = true
-> CoordinatorAgent FINAL_ACCEPTED
-> ChatService 流式输出
这个路径通常不会跑 ContextAgent,不会检索心理知识库,不会生成心理报告,也不会进入工具计划。
低风险咨询一般是这样:
TURN_STARTED
-> UnderstandingAgent 发布 intent = CONSULT
-> SafetyAgent 发布 risk = LOW
-> Coordinator 创建 context task
-> ContextAgent 读取记忆、检索 RAG、加载 skill
-> ResponseAgent 发布 support response_proposal
-> SafetyAgent 审查通过
-> CoordinatorAgent FINAL_ACCEPTED
-> Harness 创建 PsychologicalReport
-> Trace 保存
-> ChatService 流式输出
-> 工具计划写 Excel 台账
这里会生成心理报告,因为 intent 不是 CHAT。但如果 risk 仍是 LOW,工具队列只会写 Excel,不会创建风险个案,也不会发高风险预警。
高风险路径更保守:
TURN_STARTED
-> 高风险硬信号提高 root task 优先级
-> UnderstandingAgent 直接或经模型得到 intent = RISK
-> SafetyAgent 评估 risk = HIGH
-> SafetyAgent 发布 SAFETY_OVERRIDE
-> Coordinator 创建 context task,优先级为 CRITICAL
-> ContextAgent 加载高风险 skill 和必要知识
-> ResponseAgent 发布 support response_proposal,带高风险处理规则
-> SafetyAgent 审查候选回复
-> 如果缺少即时安全指引,发布 critique 并要求修订
-> 审查通过后 CoordinatorAgent FINAL_ACCEPTED
-> Harness 创建 PsychologicalReport
-> Trace 保存
-> ChatService 流式输出
-> 工具队列写 Excel、创建风险个案、发送或记录预警
这个路径里最关键的是 SAFETY_OVERRIDE 和候选回复审查。高风险不是只在报告里改个标签,而是会影响意图、风险、上下文优先级、回复 prompt 和后续工具计划。
为什么这个 runtime 适合 MindBridge
[!NOTE] MindBridge 是校园心理场景,不是普通聊天 demo。它需要在几件事之间保持平衡。
第一,普通问题要轻,学生问代码、作业、翻译、校园事务时,系统应该像普通助手一样直接回答。它不能每轮都查心理知识库,也不能动不动生成心理报告。
第二,咨询问题要有上下文,学生说压力、焦虑、失眠,系统不能只靠一句当前输入回答。它要看短期记忆、必要时查校园心理知识库,还要把 supportive response、转介建议、焦虑稳定、睡眠支持、学业压力这些 skill 规则放进 prompt。
第三,高风险问题要保守,高风险词先于模型判断。SafetyAgent 独立评估风险,还能发布 SAFETY_OVERRIDE。候选回复必须再过一次安全审查。这个路径牺牲了一点灵活性,但换来的是更明确的安全边界。
第四,后台动作要可控,写 Excel、建个案、发预警不能由模型自由决定,也不应该阻塞学生端流式回复。runtime 只产出结构化结果,harness 和工具队列再按固定规则处理。
第五,整条链路要能解释,黑板上的 events、tasks、artifacts 会进入 trace。管理员可以看到这轮对话是怎么走到最终回复的。这比只保存一段模型输出靠谱得多。
八、Harness
[!NOTE] 这个项目里有两个harness概念
第一个是 MindBridgeAgentHarness,它是线上业务链路的一部分。它解决的是 HTTP、Agent、数据库、工具任务混在一起的问题。把一次对话请求包装成一个完整业务单元,输入脱敏、会话解析、Agent run、报告落库、trace 保存、工具计划和消息持久化都在这里统一处理。
第二个是 Engineering Harness,它是工程验收工具。它用临时 SQLite、内存短期记忆和本地输出跑一批可重复用例,验证风险识别、Agent 路由、skills、RAG、API 和工具队列有没有回归。
Harness 的价值不是为了多包一层,而是把“不稳定的模型行为”和“确定性的业务闭环”分开。Runtime 只负责判断和组织模型上下文,Harness 负责业务结果怎么落库、怎么审计、怎么触发后处理。这样系统更容易测试,也更容易解释。
[!NOTE] MindBridge 里的 Harness 不是一个单纯的测试脚本,也不是 Agent 本身。它更像项目里两层不同的“运行外壳”,一层包住线上单轮对话,负责把 Agent 的推理结果接到业务闭环里。另一层包住工程验证过程,负责用可重复的环境把风险、安全、路由、RAG、API 和工具队列跑一遍。
MindBridgeAgentHarness
[!NOTE] 它的职责很明确,HTTP 和 SSE 不直接管复杂业务,Agent runtime 也不直接管落库和工具派发。
一次学生输入进来后,Harness 会先保留原始输入,再做隐私脱敏,解析或创建会话,然后调用 Agent runtime。runtime 返回意图、风险评估、检索知识、回复消息和 Agent steps 后,Harness 继续处理用户消息保存、心理报告生成、trace 保存和工具计划。
这层设计把聊天接口变薄了,ChatService.stream_chat 只需要调用 agent_harness.run(),把返回的 response_messages 交给模型流式输出,然后保存助手回复,最后再按 tool_plan 派发后台工具,也就是说,接口层关心怎么把内容流给前端,Harness 关心这一轮业务是否完整走完。
MindBridgeAgentHarness.run() 的结果也不是一段文本,而是一个结构化的 AgentHarnessOutcome。这个结果让后续逻辑不需要猜 Agent 做了什么,直接按字段处理
Agent runtime
Agent runtime 本身负责一轮对话里的 Agent 协作和路由判断。当前代码里有三种 runtime:
默认:EventDrivenAgentRuntimeService,由 AGENT_FRAMEWORK=event_driven_multi_agent 启用,也是 app/core/config.py 的默认值。
任务板 + artifact 协作模式:
CoordinatorAgent 创建任务板
-> UnderstandingAgent 产出 intent artifact
-> SafetyAgent 产出 risk artifact,并在高风险时发布 SAFETY_OVERRIDE
-> ContextAgent 在 CONSULT/RISK 或中高风险时补充记忆、RAG、skill 上下文
-> ResponseAgent 产出候选回复 prompt
-> SafetyAgent 审查候选回复
-> CoordinatorAgent 最终采纳可用回复方案
这套 runtime 的动态路由逻辑是:
- 普通 CHAT:会做意图和安全 artifact,但不会进入心理 RAG 上下文,也不会生成心理报告,最后由 ResponseAgent 以普通聊天模式组织回复 prompt。
- CONSULT:会进入 ContextAgent,读取历史、生成记忆摘要、检索心理知识库、选择相关 skill,再由 ResponseAgent 以支持模式组织回复 prompt。
- RISK 或 SafetyAgent 触发 SAFETY_OVERRIDE:风险会提升到 HIGH,回复 prompt 会带高风险安全约束,后续会生成心理报告并进入工具计划。
Trace
Trace 是这层 Harness 里很值得讲的一点。每轮运行都会保存原始输入、脱敏输入、记忆摘要、路由意图、风险等级、Agent steps、检索证据、回复消息和评估结果。管理员可以用 trace 回看一轮请求为什么被路由成 CONSULT 或 RISK,也能检查某次回复到底用了哪些知识。
MindBridgeAgentHarness 的作用
很多 Agent 项目容易把 HTTP、Agent、落库、工具调用混在一起。我们这个项目在外层增加了 MindBridgeAgentHarness,它负责单轮 Agent run 的业务编排。简单说,MindBridgeAgentHarness 就是 一次对话请求的总调度员。它本身不是“负责聊天的大模型 Agent”,也不是 HTTP 接口。
流程如下
- 学生端调用 POST /api/chat/stream,ChatService.stream_chat() 调用 MindBridgeAgentHarness.run()。
- Harness 对原始输入做 strip(),并生成脱敏后的 model_input。
- Harness 根据 sessionId 复用会话;没有 sessionId 时新建 ChatSession。
- Harness 调用真正的 Agent runtime,让 runtime 完成记忆读取、意图路由、知识库检索、风险评估和回复 prompt 规划。
- Harness 把用户原始消息保存到业务数据库(线上默认 MySQL;harness/测试可切 SQLite),同时把脱敏后的短期记忆写入 Redis。
- 如果 runtime 输出的 intent 不是 CHAT,也就是 CONSULT 或 RISK,Harness 创建 PsychologicalReport;普通聊天不创建报告。
- Harness 保存 trace,记录本轮为什么这样路由、用了哪些知识、评估结果是什么、最终准备了哪些回复消息。
- Harness 生成工具计划。只要有心理报告,就会有工具计划;具体后处理由风险等级决定。
- Harness 把 AgentHarnessOutcome 返回给 ChatService。
- ChatService 使用 AiClient.stream(outcome.response_messages) 流式生成最终助手文本,通过 SSE 返回前端。
- 流式结束后,ChatService 调 Harness 保存助手消息,再派发工具任务。
[!NOTE] MindBridgeAgentHarness 的核心价值是让 Agent 输出能被业务系统接住
- CONSULT/RISK 要生成 PsychologicalReport。
- CHAT 不能生成心理报告。
- 有报告才进入工具计划。
- 高风险报告要创建个案和预警任务。
- 普通编程问题不能触发后台预警。
- 每轮都要保存 trace,方便管理员审计。
它把这些判断集中在一层,避免散落在接口、Agent、数据库服务和工具服务里。你可以这么理解,ChatService 负责“接待和把回复流出去”,AgentRuntime 负责“几个 Agent 怎么思考和协作”,MindBridgeAgentHarness 负责“这一轮业务闭环怎么跑完”。
Engineering Harness
它不服务线上请求,而是服务工程验收。启动时它会关闭向量依赖,把邮件预警改成 log 模式,并把 Redis 短期记忆替换成内存实现。这些设置让验证过程不依赖真实 MySQL、Redis、模型服务或邮件服务
[!NOTE] 当前 Engineering Harness 覆盖 6 类 suite,Risk Safety、Agent Routing、Standard Skills、RAG、API 和 Tool Queue,它测的不是一个小函数,而是完整行为。
Risk Safety Harness:跑中文高风险、英文高风险、低风险咨询和普通聊天,检查报告是否生成、预警任务是否入队、学生端是否泄露后台字段。
Agent Routing Harness:强制 agent_framework=custom,检查 CHAT、CONSULT、RISK 三类输入分别走了哪些 Agent。
Standard Skills Harness:检查标准 skill 是否加载、咨询和高风险场景是否选中正确 skill、交接摘要是否包含关键字段。
RAG Harness:跑内置 60 条评测 case,计算 Recall@K、Precision@K、MRR、NDCG@K 和 HitRate。
API Harness:检查健康检查、Basic Auth、学生/管理员权限、聊天 SSE、知识库导入和状态接口。
Tool Queue Harness:检查高风险报告是否生成 Excel、case、alert 三个任务,也检查依赖、幂等、限流和 dead letter。
我本地 target/harness/rag-eval-report.json 的 RAG 指标如下,大家也可以自测一下
TopK: 4
Total cases: 60
Recall@K: 0.9667
Precision@K: 0.6458
HitRate: 0.9667
MRR: 0.9083
NDCG@K: 0.9053
两者区别
Agent Runtime Harness 是线上业务链路的一部分。它处理一轮真实用户请求,输出 AgentHarnessOutcome,并把结果写入消息、报告、trace 或工具计划。追求这一轮对话能不能安全、完整、可审计地跑完
Engineering Harness 是工程验证工具。它主动搭环境、重建数据库、替换外部依赖,然后批量跑断言。追求改完代码以后,项目的核心链路有没有回归
[!NOTE] 最简单的区分方式是
MindBridgeAgentHarness 管单轮业务,app.harness.runner 管工程验收。前者在请求路径里,后者在测试或交付验证路径里。前者产生用户会话、报告和 trace,后者产生 harness-report.json 和 rag-eval-report.json。
九、上下文管理与上下文压缩
分层上下文管理
[!NOTE] MindBridge 的上下文管理分成几层:
- Redis:保存短期记忆,默认最多 40 条消息,TTL 是 86400 秒。
- 业务数据库:保存完整会话消息、心理报告、trace 和工具记录;线上默认 MySQL,harness 和测试可切 SQLite。
- 内部记忆摘要:为 Agent 判断和回复 prompt 提供压缩后的历史背景。
- 最近原文窗口:保留最近若干条脱敏后的原文消息,让模型看到近期真实语气、措辞变化和安全线索。
- RAG 上下文:只在心理咨询、风险或中高风险场景按需注入知识库内容。
- Trace:保存每轮 Agent 的步骤、摘要、检索证据、评估结果和 prompt 消息,供后台复盘。 默认配置比较保守:
redis_memory_max_messages = 40
redis_memory_ttl_seconds = 86400
memory_compaction_enabled = true
memory_compaction_recent_messages = 8
memory_summary_max_chars = 500
chat_history_limit = 10
knowledge_chunk_size = 512
knowledge_chunk_overlap = 64
knowledge_candidate_k = 16
knowledge_top_k = 4
knowledge_hybrid_vector_weight = 0.65
knowledge_hybrid_bm25_weight = 0.35
knowledge_rerank_enabled = true
[!NOTE] chat_history_limit = 10 还会在最后做一次兜底裁剪
_bounded_model_history() 最多保留 chat_history_limit * 2 条消息,也就是默认 20 条。通常压缩后是“历史摘要 system 消息 + 最近 8 条脱敏原文 + 当前输入”,不会触发 20 条上限,这个上限主要防止异常情况下 prompt 继续膨胀。
2. 一轮请求里的上下文流向
学生消息进来后,MindBridgeAgentHarness 会先做:
original_input = request.message.strip()
model_input = PrivacySanitizer.sanitize(original_input)
也就是说:
- original_input 会保存到业务数据库里的 chat_messages,用于完整会话记录和后台追溯。
- model_input 会传给 Agent runtime,用于模型分类、摘要、检索 query 改写和回复 prompt。
- Redis 短期记忆写入时会再次脱敏,因此 Redis 里保存的是脱敏后的短期上下文。 这点很重要,业务系统保留原始记录,方便审计,模型侧和 Redis 侧尽量使用脱敏文本,降低隐私暴露面。
3. 事件驱动链路里的ContextAgent
当前默认 runtime 是 event_driven_multi_agent。这条链路由 CoordinatorAgent 根据黑板 artifact 判断是否需要上下文任务。
默认流程可以理解为:
UnderstandingAgent 产出 intent
SafetyAgent 产出 risk
CoordinatorAgent 判断是否需要 context
ContextAgent 在需要时加载历史、压缩上下文、检索 RAG、选择 skill
ResponseAgent 组织候选回复 prompt
SafetyAgent 审查候选回复
CoordinatorAgent 最终采纳
ContextAgent 只有在下面情况才会运行:
- intent 是 CONSULT。
- intent 是 RISK。
- risk 是 MEDIUM 或 HIGH。
- 任务明确要求上下文。 所以,对普通 CHAT,默认事件驱动链路通常不会加载完整历史摘要,也不会注入心理 RAG。它仍然会做意图和安全 artifact,但不会把普通学习、编程或校园事务强行心理化。
5. 上下文压缩怎么做
[!NOTE] 压缩逻辑在 compact_history_for_prompt()。
它先对历史消息做脱敏,然后生成一段确定性的 memoryBrief。这段摘要不是让模型自由发挥,而是按规则提炼:
- 学生近期关注了什么:最多取最近 4 条用户消息,每条裁剪到 80 字。
- 系统已经给过哪些支持:最多取最近 3 条助手回复,每条裁剪到 70 字。
- 本轮输入关注什么:当前输入裁剪到 80 字。
- 最终摘要总长度默认最多 500 字。
如果历史长度不超过 memory_compaction_recent_messages,默认是 8 条,系统会保留完整的脱敏短历史。如果历史长度超过 8 条,就把旧历史压成一条 system 消息,再拼接最近 8 条脱敏原文消息。
模型看到的大致是:
历史摘要 system 消息
+ 最近 8 条脱敏原文消息
+ 当前脱敏输入
这比全量历史更省 token,也比纯摘要更稳。因为纯摘要容易丢掉学生原话,而最近原文里往往包含情绪强度、措辞变化和安全风险线索。
6. 上下文如何进入后续 Agent
事件驱动链路里,类似职责拆给了:
- UnderstandingAgent:判断 intent。
- SafetyAgent:独立评估 risk。
- ContextAgent:在咨询、风险或中高风险时加载记忆、RAG 和 skill 上下文。
- ResponseAgent:根据 intent、risk、memoryBrief、RAG 和 skill 指引组织候选回复 prompt。 两条 runtime 的外部结果是统一的:都返回 AgentRunResult,再由 MindBridgeAgentHarness 接住,写消息、报告、trace 和工具计划。
7. RAG 上下文按需注入
RAG 不是每轮都注入。它只在心理咨询、风险或中高风险场景进入上下文。
在默认事件驱动链路里,ContextAgent 在需要上下文时做类似事情:
memoryBrief + model_input
-> 改写检索 query
-> KnowledgeService.retrieve(query, topK)
-> 选择 skill context
知识库检索配置如下:
chunk size = 512
overlap = 64
candidateK = 16
topK = 4
vector weight = 0.65
BM25 weight = 0.35
rerank enabled = true
检索流程是:
- 如果向量库可用,先取向量候选。
- 同时取 BM25 关键词候选。
- 对两路候选做分数归一和加权融合。
- 做本地 rerank。
- 取 topK。
- 对排名最好的 chunk 扩展相邻片段,也就是同 source 下 source_index - 1 到 source_index + 1。
- 再补齐其他 topK 结果。 所以“命中最好的 chunk 会扩展相邻片段,避免只截到半段危机处理流程”这句话是对的;更精确地说,是只对排名第一的 chunk 做相邻扩展。
最后,心理支持 prompt 会把这些内容组合起来:
- 记忆摘要。
- 检索知识。
- 风险评估。
- skill 指引。
- 当前脱敏输入和近期脱敏原文。
8. 为什么不是全量历史进模型
[!NOTE] 全量历史在这个项目里问题很明显。
第一,token 会越来越长,延迟和成本都会上去。
第二,旧消息会干扰当前判断。比如学生上周说过失眠,但今天只是问 Python 作业,系统不应该一直把他当成心理咨询场景。
第三,隐私暴露面太大。业务数据库可以保存原始记录,但模型 prompt 没必要长期携带完整原始隐私。
第四,模型容易在长上下文里抓错重点。多轮对话里会夹杂学习、生活、情绪和求助内容,把所有内容无差别塞给模型,反而会降低当前轮判断的稳定性。
9. 为什么不用纯滑动窗口
心理咨询不是普通问答。学生可能隔了很多轮才重新提到某个压力源,比如考试、家庭关系、睡眠问题。只保留最近消息,模型可能看不到更早的背景。
纯滑动窗口很轻,但记忆太短。MindBridge 用摘要补旧背景,再用最近脱敏原文保留细节,这个组合更适合连续陪伴场景。
10. 为什么不用纯摘要
纯摘要也有风险。学生原话里可能有非常关键的表达:
我已经三天没睡了
我不想活了
我怕自己控制不住
如果被压成“学生压力较大”,风险强度就丢了。所以项目只压缩旧历史,最近消息仍然保留脱敏后的原文。摘要负责背景,原文负责当前判断和风险线索。
11. 为什么 Redis 和 MySQL 都要用
Redis 适合每轮快速读取短期上下文,响应快,结构简单,还可以设置 TTL,避免短期记忆无限增长。
业务数据库适合保存完整会话、心理报告、trace、工具任务和管理员后台记录,支持审计、回放、风险留档和问题排查。
[!NOTE] 只用 Redis 会丢历史,也不适合做审计,只用 MySQL 又会让每轮上下文读取更重。两者分工后,聊天体验和业务留痕都能保住。
12. Trace 在上下文管理里的作用
Trace 会保存每轮运行的:
原始输入。
脱敏输入。
记忆摘要。
路由意图。
风险等级。
Agent steps。
检索证据。
回复消息。
心理评估结果。
默认事件驱动链路里的 collaboration events、tasks 和 artifacts。
它不直接影响模型回复,但能让管理员复盘:
- 这轮为什么被判成 CONSULT 或 RISK。
- 普通聊天为什么没有走心理 RAG。
- 高风险判断来自规则、模型评估,还是 SAFETY_OVERRIDE。
- 某次回复带了哪些知识片段和 skill 指引。
十、Memory
[!NOTE] 本项目的memory包括6层
第一层是会话短期记忆。代码在 app/services/memory.py,类名是 RedisShortTermMemoryStore。它用 Redis 保存某个会话最近的消息,key 的格式是 mindbridge:short-term-memory:
第二层是业务数据库里的完整聊天记录。ChatSession 和 ChatMessage 定义在 app/models/entities.py。学生和助手的消息都会落到 chat_messages 表里。Redis 更像热缓存,数据库才是完整记录。Redis 没有命中时,系统会从数据库取最近 40 条回填到 Redis。
第三层是内部记忆摘要。长历史不会全部进入 prompt。系统会把较早的历史压缩成简短摘要,再保留最近若干条脱敏原文。这个摘要叫 memoryBrief,它是给 Agent 和 trace 用的,不是给学生看的结论。
第四层是最近原文窗口。摘要能省 token,但摘要也会丢细节。学生原话里的强度词、时间、犹豫、求助方式、风险表达,往往比抽象摘要更有判断价值。所以项目会保留最近 8 条脱敏后的原文消息,让模型看到最近对话的真实语气。
第五层是 Agent 私有记忆。当前默认的事件驱动 runtime 里,AgentPrivateMemory 会给不同 Agent 分配隔离的 Redis key,比如 agent:SafetyAgent:
第六层是 trace 记忆。AgentTraceService 会把每轮 Agent run 的输入、脱敏输入、memory brief、Agent steps、检索结果、评估 JSON、协作事件、任务和 artifact 写进 agent_run_traces。这不是 prompt memory,而是审计 memory。它让管理员和开发者能复盘这一轮为什么这么判断。
Redis 短期记忆怎样保存
RedisShortTermMemoryStore 的接口很少,主要是 load_recent()、append()、replace() 和 messages_from_rows()。
append() 用 rpush 把一条消息追加到 Redis list,随后用 ltrim 把长度裁到最近 40 条,再用 expire 设置 86400 秒过期时间。这个设计让短期记忆不会无限增长,也让过期会话自然释放缓存空间。
load_recent() 从 Redis 读取最近消息。它会解析 JSON,取出 role 和 content,并再次通过 PrivacySanitizer 处理内容。即使 Redis 里意外混入未脱敏内容,读取阶段也会做一次保护。
replace() 用在 Redis 为空、数据库有历史时。系统从 chat_messages 表取最近 40 条,转成 AiMessage,然后整批写回 Redis。这样下一轮就能走 Redis 热缓存,不必每次都查数据库。
每条 Redis 消息的 JSON 结构很简单:
{
  "role": "user",
  "content": "电话 [已脱敏]",
  "createdAt": "2026-07-06T..."
}
这里没有保存额外画像,也没有把风险等级、诊断标签塞进会话短期记忆。短期记忆只保留对话内容本身,而且内容会被脱敏。
为什么同时用 Redis 和数据库
只用 Redis 不够。Redis 有 TTL,也可能被清理,不适合承担完整审计和报告留档。心理健康场景里,后续人工接手、风险个案、管理员复盘都需要可靠记录。
只用数据库也不理想。每轮对话都从数据库拉长历史,再交给模型,会让读取和上下文构造变重。Redis 更适合保存最近会话窗口,读写快,结构简单。
MindBridge 把两者分开:Redis 负责短期上下文,数据库负责完整业务记录。Redis miss 时从数据库回填,这样既保留响应速度,也不丢长期留痕。
这种分层还方便演示和部署。开发环境里可以用 SQLite 或本地 MySQL,Redis 不可用时主链路仍然能跑。正式环境里,Redis 提供更好的短期记忆体验,数据库负责审计和后台流程。
默认事件驱动链路里的 ContextAgent
当前仓库默认 runtime 是 event_driven_multi_agent,配置在 app/core/config.py,默认值是:
agent_framework = "event_driven_multi_agent"
事件驱动链路的基本流程是:
UnderstandingAgent 产出 intent
SafetyAgent 产出 risk
CoordinatorAgent 判断是否需要 context
ContextAgent 在需要时准备 memory、RAG 和 skill
ResponseAgent 提出候选回复
SafetyAgent 审查候选回复
CoordinatorAgent 最终采纳
ContextAgent 不是每轮都运行。CoordinatorAgent 会根据黑板上的 intent 和 risk 判断是否需要上下文任务。只有满足下面情况时,才会创建或执行 context 任务:
intent 是 CONSULT
intent 是 RISK
risk 是 MEDIUM 或 HIGH
任务明确要求 CONTEXT 能力
这意味着普通聊天不会被强行心理化。学生问代码、作业、翻译、路线、校园事务时,系统通常不需要读取完整心理上下文,也不需要注入 RAG 心理知识库。它仍然会做意图判断和安全评估,但不会走重上下文链路。
当 ContextAgent 运行时,它会先 _load_history()。这个方法优先读 Redis。如果 Redis 为空,就从 chat_messages 按创建时间倒序取最近 40 条,再反转成正常对话顺序,转成脱敏消息后写回 Redis。
然后它调用 compact_history_for_prompt(),拿到压缩后的 prompt 历史和确定性摘要。接着它尝试用自己的模型客户端生成 1 到 3 条中文记忆要点,系统提示明确要求“不输出风险等级或诊断”。如果模型摘要失败,就回退到确定性摘要。
最后,ContextAgent 会根据 intent 和 risk 决定是否检索知识库、是否加载 skill context。它产出的 artifact kind 是 context,里面有:
memoryBrief
modelHistory
knowledgeQuery
retrievedKnowledge
skillContext
privateMemoryKey
ResponseAgent 后面会读取这个 artifact,把 memory、知识片段和 skill 指引合进候选回复 prompt。
Agent 私有记忆为什么要单独存在
事件驱动版本里,除了会话短期记忆,还有 AgentPrivateMemory。它不是给学生建立长期画像,而是给每个 Agent 保留自己的工作记录。
UnderstandingAgent 会记录类似:
intent=CONSULT; topic=mental_health_support
SafetyAgent 会记录类似:
risk=LOW; summary=检测到压力或情绪求助表达
review approved=True; reason=response proposal satisfies current safety constraints
ContextAgent 会记录类似:
context intent=CONSULT; risk=LOW; retrieved=4
ResponseAgent 会记录类似:
response mode=support; intent=CONSULT; risk=LOW
这些记录分别写到隔离 key 里,格式类似 agent:
私有记忆的价值在于隔离。SafetyAgent 的风险记录不能直接变成学生端话术,ResponseAgent 的表达策略也不应该影响 UnderstandingAgent 的意图判断。每个 Agent 记自己的事,既能延续工作状态,又能减少上下文污染。
这对心理健康项目很重要。后台语言和学生端语言必须分开。后台可以记录 risk、confidence、summary,学生端应该得到温和、具体、不贴标签的支持。私有记忆帮助系统把这些边界留在代码结构里。
历史为什么要压缩
[!NOTE] 聊天系统最容易犯的错误,是把历史越塞越长。刚开始没问题,聊多了以后 prompt 变慢、变贵,还会带来判断干扰。
心理支持场景里,长历史的问题更明显。学生上周说过失眠,今天可能只是问 Python 作业。系统如果一直把旧的失眠记录放在最显眼的位置,可能会把普通问题误判成心理咨询。相反,如果完全不看历史,学生连续倾诉几轮后,系统又会像第一次见面一样生硬
MindBridge 的做法是折中:旧历史压成内部摘要,最近消息保留脱敏原文。摘要负责延续背景,最近原文负责保留细节和风险线索。
压缩逻辑在 compact_history_for_prompt()。它会先脱敏历史,然后调用 summarize_history_for_memory() 生成确定性摘要。摘要按规则拼出来,不完全依赖模型:
学生近期关注:最近 4 条用户消息,每条最多 80 字
已给过的支持:最近 3 条助手回复,每条最多 70 字
本轮输入关注:当前输入最多 80 字
最终摘要默认最多 500 字。即使历史很长,也不会无限膨胀。
如果历史消息数不超过 memory_compaction_recent_messages,默认 8 条,系统会保留这些脱敏消息。如果超过 8 条,就生成一条 system 消息,内容大致是:
历史摘要(仅供 MindBridge 内部上下文使用;不要向学生展示;不要据此输出诊断、风险等级或后台标签):
...
然后再拼接最近 8 条脱敏原文。
这个 system 消息写得很克制。它明确告诉模型:这是内部上下文,不要向学生展示,不要输出诊断,不要输出风险等级,不要泄漏后台标签。memory 在这里不是学生画像,而是本轮判断的辅助材料。
十二、本项目采用的 Agent 范式
总体范式
[!NOTE] MindBridge 的学生对话入口由 MindBridgeAgentHarness 统一承接。它负责输入脱敏、会话解析、调用 Agent runtime、保存用户消息、生成心理报告、写入 trace,并在学生端回复之后触发工具计划。
当前默认 runtime 是事件驱动黑板式多 Agent 协作:
- CoordinatorAgent 创建 root task,维护任务板、预算、安全门槛、冲突仲裁和最终采纳。
- UnderstandingAgent 独立理解输入,发布 intent artifact,意图包括 CHAT、CONSULT、RISK。
- SafetyAgent 独立做风险评估,必要时发布 SAFETY_OVERRIDE;同时审查候选回复是否安全。
- ContextAgent 在心理支持链路中加载记忆、改写 RAG query、检索知识库并组织 skill 上下文。
- ResponseAgent 基于黑板上的意图、风险、上下文和安全约束提出候选回复 prompt。
- 最终回复必须经过 SafetyAgent 审查并由 CoordinatorAgent 采纳。 这不是 ReAct 无限循环,也不是单 Agent 大 prompt。它是有预算的多 Agent 协作:默认最多 8 轮,每轮最多 4 个 claim,每个 Agent 最多 claim 3 次。
2. 为什么不用 ReAct 范式
ReAct 适合开放式工具使用,由模型在 Thought / Action / Observation 中不断决定下一步。但校园心理场景不能让模型自由决定是否做风险评估、是否进入高风险处理、是否调用后台工具。
MindBridge 把这些关键动作放在框架和后台服务里控制:
- 默认事件驱动 runtime 中,所有学生输入都会经过独立风险评估和候选回复安全审查。
- 普通 CHAT 不进入 RAG,不生成心理报告,也不会触发后台工具队列。
- CONSULT / RISK 会生成心理报告,后续工具处理由 harness 和 tool queue 决定,不由模型自由触发。
- runtime 有轮数和 claim 次数预算,避免无限循环。
- 每轮会保存 trace,便于复盘 intent、risk、RAG、response prompt 和安全审查过程。 因此,项目不是把工具选择权完全交给大模型,而是让模型在受控任务中产出 artifact 或 prompt,再由 runtime 和后台策略接管安全、报告和工具执行。
十三、RAG
RAG 知识库怎么做
RAG 只在 CONSULT 和 RISK 场景触发,普通 CHAT 不查知识库。原因很简单,如果普通编程、作业、校园事务也去查心理知识库,不但延迟变高,回答还容易被心理 prompt 带偏。
知识来源有两类:
- 系统启动时会导入一批内置的校园心理支持知识种子。
- 管理员可以通过后台接口追加文本知识,也可以上传 PDF 或文本文件,PDF 会先抽取文本再入库。 入库后会切成 chunk,默认 chunk size 是 512,overlap 是 64。这个策略比较朴素,但在小型校园心理知识库里够稳定,也方便评测。后续如果知识库变大,可以升级成按标题、政策条款或语义段落切块。
检索链路不是只接了一个 Chroma。主路径是:
- 用 embedding 走 Chroma 向量召回。
- 同时用 BM25 做关键词召回。
- 对向量分和 BM25 分做归一化和权重融合。
- 用本地 reranker 结合 query 覆盖率、短语命中、词面相似度再排一次。
- 对第一名 chunk 做前后文扩展,缓解固定切块造成的语义断裂。
如果没有 OpenAI API key、chromadb 不可用,或者 embedding 调用失败,系统会降级到本地 BM25 + hybrid reranker。这个降级很重要,因为面试演示或者本地部署时,不一定一直有完整向量链路。
最近一次已有 harness 报告里,RAG 数据集是 60 条,TopK=4,Recall@K=0.9667,HitRate=0.9667,MRR=0.9083,NDCG@K=0.9053。这个结果可以证明检索链路不是只停留在“能查到”,而是有基本的召回和排序评测。
降级策略
ChromaKnowledgeStore 会判断:
- 是否启用向量库。
- 是否配置 OPENAI_API_KEY。
- 是否安装 chromadb。
- embedding API 是否可用。 当 KNOWLEDGE_VECTOR_REQUIRED=false 时,如果向量链路不可用,系统会降级到:
local BM25 + hybrid_score reranker
当 KNOWLEDGE_VECTOR_REQUIRED=true 时,向量链路不可用会直接抛出错误,适合验收要求必须使用 Chroma 的场景。
RAG 在整体链路里的位置
学生端发消息后,HTTP 层并不直接把消息丢给大模型。ChatService 会调用 MindBridgeAgentHarness,由 harness 处理一轮 Agent run。harness 会做几件事:保存会话、对输入脱敏、调用 Agent runtime、保存用户消息、必要时生成心理报告、写入 trace,并在回复后触发工具队列。
[!NOTE] event_driven_multi_agent这条链路使用事件驱动多 Agent 协作CoordinatorAgent 维护任务板
UnderstandingAgent 产出意图 artifact,SafetyAgent 产出风险 artifact 并审查候选回复,ContextAgent 按需聚合记忆、RAG 和 skill,ResponseAgent 生成候选回复 prompt。最后要经过 SafetyAgent 审查和 CoordinatorAgent 采纳。
MindBridge 的 RAG 是动态上下文分支。默认事件驱动版本由 ContextAgent 触发
内置知识库
[!NOTE] MindBridge 的内置知识库
- campus-mental-health.md:校园心理支持总则,说明 MindBridge 的定位、边界和常见主题。
- risk-policy.md:LOW、MEDIUM、HIGH 风险口径,高风险时的报告、Excel 台账和预警规则。
- anxiety-panic-grounding.md:焦虑、恐慌、grounding、呼吸和灾难化思维整理。
- low-mood-depression-support.md:情绪低落、抑郁倾向、行为激活和社交连接。
- sleep-routine-self-care.md:睡眠卫生、固定起床时间、午睡、咖啡因和作息。
- academic-stress-and-burnout.md:学业压力、拖延、倦怠、任务拆解。
- exam-season-guidance.md:考试季复习计划、考前睡眠和考后情绪。
- relationships-and-family.md:室友冲突、恋爱、人际疏远、家庭期待和边界。
- adjustment-and-transition.md:新生适应、转专业、毕业、实习等阶段转换。
- counselor-referral-and-resources.md:校内心理中心、辅导员、可信任支持人和紧急资源。
- privacy-boundaries-and-ethics.md:隐私、保密边界、危机干预例外和伦理表达。
知识入库流程与切块方式
[!NOTE] 入库入口有三个。
- 启动时的 seed_data,负责内置 md。
- POST /api/admin/knowledge,管理员传 source 和 content,适合追加一段文本。
- POST /api/admin/knowledge/file,管理员上传 PDF、Markdown 或 txt 文件,适合维护正式文档。 进入 KnowledgeService.ingest(source, content) 后,流程是这样的:
- 用 chunk_text() 把原始文本切成片段。
- 删除这个 source 在 Chroma 里的旧向量。
- 删除数据库中这个 source 的旧 chunk。
- 把新的 chunk 写入 knowledge_chunks 表。
- 如果向量能力可用,生成 embedding,并写入 Chroma。
- 提交数据库事务,返回 chunk 数量。 source 很重要。它通常是文件名,比如 risk-policy.md,也可以是管理员提交的自定义来源名。后续检索结果会带着 source,回复 prompt 里会拼成 - [source] content 这样的形式。这样 trace 和后台排查时能知道某条建议来自哪份知识。
KnowledgeChunk 表里有几个字段:source、source_index、content、embedding_json。source_index 是 chunk 在同一 source 里的顺序。后面做相邻上下文扩展时,就是靠 source 和 source_index 找前后片段。embedding_json 是可选字段,向量主路径可用时会把 embedding 缓存在数据库里,减少重复请求 embedding 接口。
[!NOTE] 切块方式
当前切块是固定字符窗口,不是复杂语义切分。代价也很清楚:Markdown 标题、段落、政策条款可能被切断。所以项目后面又做了"相邻上下文扩展",用来弥补固定窗口的断裂。chunk_text() 会先把所有空白压成单个空格,然后按配置切块。
默认参数在 Settings 里:
knowledge_chunk_size = 512
knowledge_chunk_overlap = 64
也就是说,每个 chunk 默认 512 个字符,相邻 chunk 重叠 64 个字符。步长是 512 - 64 = 448。这样做简单、稳定、不依赖额外模型,也方便演示和测试。
如果以后要优化,第一步可以把固定字符切块升级成结构化切块,优先按 Markdown 标题、段落、列表项和政策条款分段,再控制最大长度。对心理知识库来说,这会比纯字符窗口更稳,因为一个建议、一个边界或一条高风险规则最好不要被切到两段里。
检索流程
KnowledgeService.retrieve(query, top_k) 是检索总入口。默认:
knowledge_top_k = 4
knowledge_candidate_k = 16
实际流程是:
query
-> 取 topK 和 candidateK
-> 从数据库读取全部 KnowledgeChunk
-> 如果向量可用,走 Chroma 召回 candidateK 个候选
-> 本地 BM25 召回 candidateK 个候选
-> 对向量分和 BM25 分分别归一化
-> 按 0.65 / 0.35 加权融合
-> 截取候选集合
-> 本地 rerank
-> 返回 topK
-> 对第一名做相邻 chunk 扩展
这不是只查 Chroma,也不是只查关键词。它把语义召回和词面召回放在一起。
向量召回适合处理意思相近但词不完全一样的问题。比如学生说"我心跳很快、感觉要失控",知识库里可能写的是"恐慌"、"生理唤醒"、"grounding"。向量召回更容易把它们连起来。
BM25 适合处理明确关键词。比如 HIGH、self-harm、suicide、Excel ledger、辅导员、心理中心。这些词出现在政策文本里时,BM25 会很有用。
心理场景里两者都需要。只靠向量可能会漏掉政策词,只靠关键词又可能听不懂学生的自然表达。
BM25 和中文 token 处理
[!NOTE] BM25 在 knowledge.py 里实现,tokenize() 会提取英文、数字、下划线词,也会处理中文。
中文处理有两层:
- 先把每个中文字符作为 token。
- 再把连续中文拼起来,生成中文 bigram。 比如"心理中心"会有单字 token,也会生成类似"心理"、"理中"、"中心"的二字片段。这个实现不如专业中文分词细,但足够轻量,适合项目里的短知识库和评测 harness。它避免了完全按空格切中文导致 BM25 基本失效的问题。
BM25 公式里使用了常见参数:
k1 = 1.5
b = 0.75
每个 query term 会根据词频、文档频率、chunk 长度做打分。如果 query 中某个词重复出现,还会用 1 + log(query_frequency) 做一点 query boost。
[!NOTE] 分数融合
向量分和 BM25 分的量纲不同,不能直接相加。项目先分别做归一化。
normalize_scores() 会找出正分里的最低分和最高分。如果所有正分都一样,就把正分统一设为 1。否则用 min-max 归一化,把分数压到 0 到 1。
默认融合权重是:
knowledge_hybrid_vector_weight = 0.65
knowledge_hybrid_bm25_weight = 0.35
融合公式可以理解成:
fused = (vector_score * 0.65 + bm25_score * 0.35) / (0.65 + 0.35)
如果没有向量结果,向量权重会变成 0,只用 BM25。如果两个权重都被配置成 0,系统会把 BM25 权重兜底设为 1,避免排序完全失效。
这里的权重也能看出设计偏好:系统更相信语义召回,但保留较高的关键词权重。对心理知识库来说,这是合理的。学生表达经常很口语,向量能吃到语义;风险政策又有明确术语,BM25 能把术语拉回来。
本地 rerank
融合排序后,项目还会做本地 rerank。这个 reranker 不是 cross-encoder,也不再调用模型。它是一个确定性的词面重排函数,核心在 rerank_score():
rerank_score =
  base_score * 0.55
  + lexical * 0.25
  + coverage * 0.15
  + phrase * 0.05
这里的 base_score 是前面融合后的分数。
lexical 来自 hybrid_score()。它又由两部分组成:
hybrid_score = token_cosine * 0.75 + keyword_score * 0.25
- token_cosine 会把 query 和 chunk 都 token 化,计算词频向量的余弦相似度。keyword_score 会看 query 里按标点和空白切出来的词,有多少能在 chunk 里直接出现。
- coverage 看 query token 有多少被 chunk 覆盖。这个指标对"学生问得很具体"的情况比较有用。
- phrase 会把 query 和 content 都压掉空白后比较,如果完整 query 出现在 content 中,就给 1。否则退回 keyword score。
上下文扩展
固定字符切块有一个问题,最相关的 chunk 可能只包含规则的一半。比如某个 chunk 命中了"高风险",但前一段才解释什么叫 immediate danger,后一段才说通知辅导员和管理员。直接把单个 chunk 塞进 prompt,模型可能拿不到完整上下文。
MindBridge 的做法是只扩展第一名结果。_expand_best() 会对最高分 chunk 调 _expand():
best chunk
-> 找同一 source 里 source_index - 1 到 source_index + 1 的片段
-> 按 source_index 排序
-> 拼成第一条 SearchResult
其他 topK 结果保持原样,用来补充不同来源的证据。
这个策略比较克制。它不会把每个候选都扩展成三倍长度,否则 prompt 会很快变脏。它只给最可能有用的第一条补上下文,同时保留其他候选的多样性。
评测怎么做
项目有专门的 RAG 评测集:app/rag_eval/mindbridge-rag-eval.json。当前是 60 条 case。每条 case 包含问题、期望 source 和期望 terms。
评测入口是:
python3 -m app.rag_eval.runner
Engineering Harness 里也会跑 RAG suite:
python3 -m app.harness.runner
evaluate_case() 会调用 KnowledgeService.retrieve(question, top_k),然后看 topK 结果里有没有相关内容。相关性的判断很朴素:如果 source 命中 expectedSources,算相关;或者内容里出现 expectedTerms 中的词,也算相关。它不是 LLM judge,所以结果更稳定,但也没有语义评审那么细。
指标包括:
- Recall@K:topK 里是否至少命中一个相关结果。
- Precision@K:topK 中相关结果的比例。
- MRR:第一个相关结果排名越靠前,分越高。
- NDCG@K:考虑相关结果在排序中的位置。
- HitRate:有命中的 case 占比。 当前 target/harness/rag-eval-report.json 的 60 条 harness 指标是:
totalCases = 60
topK = 4
Recall@K = 0.9667
Precision@K = 0.6458
MRR = 0.9083
NDCG@K = 0.9053
HitRate = 0.9667
这组指标来自 2026-06-20 的 harness 报告。仓库里还有一个 target/rag-eval-report.json,那是另一轮 5 条样本的直接 runner 输出。讲 60 条指标时要说明引用的是 harness 报告,避免把两个报告混在一起。
Harness 还设置了通过门槛:
totalCases >= 50
hitRate >= 0.95
recallAtK >= 0.95
mrr >= 0.75
ndcgAtK >= 0.75
这说明项目不是只"接了个知识库",而是有一个可重复的检索验收入口。以后改切块、权重、rerank 或知识库内容时,可以跑 harness 看有没有回归。
十四、心理风险识别
1. 风险标签
情绪标签:
NORMAL
ANXIETY
DEPRESSED
HIGH_RISK
风险等级:
LOW
MEDIUM
HIGH
分数规则:
| 情绪 | 默认分数 | 风险 |
|---|---|---|
| NORMAL | 0.0 | LOW |
| ANXIETY | 2.0 | LOW |
| DEPRESSED | 3.0 | MEDIUM |
| HIGH_RISK | 4.0 | HIGH |
最终风险还会用 risk_from_score 修正,避免模型给出分数较高但风险等级偏低。
2. 评估顺序
PsychologicalAssessmentService.assess 的顺序:
- 高风险词库硬规则优先。
- 调用模型生成严格 JSON。
- 解析 JSON 得到 emotion、emotionScore、risk、confidence、summary。
- 如果模型异常或 JSON 解析失败,进入关键词兜底。 高风险词库包含:
自杀, 自残, 不想活, 结束生命, 伤害自己, 轻生,
suicide, kill myself, self harm
咨询信号词包含:
焦虑, 抑郁, 压力, 失眠, 难过, 崩溃, 痛苦, 无助, 心理, 咨询,
anxious, depress, stress
十五、MCP 工具服务与异步工具队列
MindBridge 项目里的 MCP用来承接心理风险场景里的后台工具动作。学生在前端和 AI 对话时,主流程负责理解学生输入、读取上下文、判断意图、检索心理知识库、做风险评估,并通过 SSE 把回复流式返回给学生。
[!NOTE] MCP 负责的是另一条线:当系统生成心理报告之后,如何把风险结果写入 Excel 台账、创建风险个案、发送预警、确认预警、追加跟进备注。
本项目的 MCP Server 写在 app/mcp_tools/server.py 里,使用 FastMCP 注册工具,服务名是 mindbridge-python-tools。当前一共暴露了 6 个工具:mindbridge_excel_report、mindbridge_case_create、mindbridge_alert_send、mindbridge_alert_ack、mindbridge_case_note_add、mindbridge_alert_notify。每个工具收到参数以后,都会打开数据库会话,读取心理报告或风险个案,然后调用 ToolOrchestrationService 执行业务动作。
项目默认的执行方式不是每次都启动 MCP Client,而是先走异步工具队列。学生端回复结束后,ChatService 会调用 MindBridgeAgentHarness.dispatch_tools。如果 TOOL_QUEUE_ENABLED=true,系统会把工具任务写入 tool_jobs 表,由 ToolQueueWorker 后台异步执行。如果关闭队列,后端才会通过 MindBridgeMcpToolClient 以 stdio 方式启动 python -m app.mcp_tools.server,再按工具名调用 MCP Server。
所以这个项目里的 MCP 可以这样理解,MCP 是工具暴露协议,工具队列是后台可靠执行机制。两者最后复用同一套 ToolOrchestrationService。
[!NOTE] 这样做的好处是,Excel 写入、个案创建、邮件预警这些逻辑不会散落在多个地方。无论未来是通过队列执行,还是被 MCP Client 调用,真正做事的业务代码都是同一套。
工具
[!NOTE] 1. 第一个工具是 mindbridge_excel_report(report_id)。
它负责把心理报告写入 Excel 风险台账。如果 Excel 文件不存在,系统会创建工作簿和表头,如果已经存在,就追加一行记录。Excel 写入还做了幂等和并发保护。
ToolOrchestrationService.write_excel 会先查 excel_records 表,如果同一个 report 已经有成功写入记录,就直接返回已有记录,不会重复写。真正写 xlsx 文件时还有 EXCEL_WRITE_LOCK,避免多个线程同时改同一个文件导致文件损坏。写入成功后,系统会保存 ExcelRecord,记录 report_id、file_path、status 和 message。
[!NOTE] 2. 第二个工具是 mindbridge_case_create(report_id)。它负责为中风险和高风险报告创建风险个案。
个案保存在 risk_cases 表里,包含 report_id、risk_level、status、owner、summary、handoff_summary、acknowledged_by、acknowledged_at 等字段。
创建时会调用 MindBridgeSkillLibrary.counselor_handoff_summary,生成给辅导员看的交接摘要。这个工具也做了幂等处理,同一个报告如果已经创建过个案,就返回已有个案。
[!NOTE] 3. 第三个工具是 mindbridge_alert_send(case_id)。
它负责基于风险个案发送或记录预警。它不是直接拿学生原始输入发邮件,而是先根据 case_id 找到 RiskCase,再找到对应的 PsychologicalReport,然后调用 notify 逻辑。通知成功后,如果个案状态还是 OPEN,系统会把它更新为 ALERT_SENT。这样后台能区分“已经创建个案”和“已经发送预警”。
预警发送支持两种模式。ALERT_EMAIL_DELIVERY_MODE=log 时,系统只写 alert_records,不真的发邮件,适合本地演示和答辩。ALERT_EMAIL_DELIVERY_MODE=smtp 时,系统会读取 SMTP_HOST、SMTP_PORT、SMTP_USERNAME、SMTP_PASSWORD、ALERT_EMAIL_FROM、ALERT_EMAIL_TO 等配置,通过 smtplib 发送邮件。如果 SMTP 配置缺失,系统会写失败记录,说明缺了哪些配置,但不会影响学生端聊天。
[!NOTE] 4. 第四个工具是 mindbridge_alert_ack(case_id, actor, note)。
用于辅导员或管理员确认接手风险个案。调用后,个案状态会变成 ACKNOWLEDGED,系统会记录确认人、确认时间,并写入一条备注。如果 note 为空,就写入默认备注。
[!NOTE] 5. 第五个工具是 mindbridge_case_note_add(case_id, actor, note)。
用于给风险个案追加跟进记录,比如“已电话联系学生”“已通知辅导员”“已预约心理中心面谈”。记录会写入 case_notes 表。心理风险处置不是发完邮件就结束,后续有没有人跟进、谁跟进、跟进了什么,都需要留下记录。
[!NOTE] 6. 第六个工具是 mindbridge_alert_notify(report_id)。
它可以直接基于报告发送或记录高风险预警,并保存 AlertRecord。从当前主链路看,更推荐的方式是先通过 mindbridge_case_create 创建个案,再通过 mindbridge_alert_send 基于个案发送预警,因为这样个案状态能一起流转。
从风险等级来看,工具触发规则很清楚。只要生成心理报告,系统就会入队 EXCEL_REPORT,把报告写入 Excel 台账。如果风险等级是 MEDIUM 或 HIGH,系统会入队 CASE_CREATE,创建风险个案。只有风险等级是 HIGH,系统才会入队 ALERT_SEND,发送或记录预警,而且 ALERT_SEND 依赖 CASE_CREATE 成功。这样可以避免“预警发出去了,但后台没有个案”的情况。
工作队列
[!NOTE] 工具队列主要解决后台动作的可靠性问题。
ToolQueueWorker 会扫描 PENDING 任务,把任务改成 RUNNING 后交给线程池执行。Excel 和个案任务走 excel_executor,邮件预警任务走 email_executor。预警还有限流,默认每分钟最多 30 条。任务失败后会延迟重试,超过最大重试次数后进入 dead_letter_records。服务重启时,原来卡在 RUNNING 的任务会恢复为 PENDING,避免任务永远挂在中间状态。
这套机制对用户体验也有帮助。学生端不需要等 Excel 文件写完,也不需要等 SMTP 邮件服务器响应。模型回复先流式返回,后台动作再异步处理。即使 Excel 或邮件失败,也不会打断学生端对话,失败原因会记录在 tool_jobs、alert_records 或 dead_letter_records 里,管理员可以在后台查看。
MCP 背后实际集成了几类工具能力。第一类是记录类能力,包括 Excel 台账和数据库记录,用来把风险评估结果沉淀下来。第二类是处置类能力,包括风险个案创建、预警发送、预警确认和个案备注。第三类是基础设施能力,包括 openpyxl、SMTP、SQLAlchemy、MySQL、工具队列、限流、重试和死信。严格说,openpyxl 和 SMTP 不是 MCP 工具名,但它们是 MCP 工具背后真正连接的外部能力。
MCP 和普通 HTTP API 的区别
普通 API 当然也能做 Excel 写入和邮件发送,但每接一个外部系统都要单独定义接口、鉴权方式和调用方式。MCP 的价值是把工具能力包装成统一的工具描述、参数和调用协议。现在项目接的是 Excel、邮件和风险个案;以后如果要接短信平台、校内工单系统、心理量表系统、咨询预约系统,也可以继续注册成 MCP 工具。
可靠性不是 MCP 自动提供的。这个项目里的可靠性来自业务后端:幂等、依赖、限流、重试、死信、失败记录和管理员后台查询。
MCP和Skills
Skill 是给模型看的业务规则,比如如何做支持性回复、如何生成辅导员交接摘要、遇到高风险表达时如何保持边界。MCP 是给系统调用工具用的,比如写台账、发预警、加备注。一个偏怎么说,一个偏怎么做。在 MindBridge 里,Skill 影响回复质量和心理支持边界,MCP 影响后台动作和外部系统联动。
十六、Skills
[!NOTE] MindBridge 里的 skills更像一组写给模型看的“心理支持操作说明”。学生发来一段话以后,系统先判断这句话属于普通聊天、心理咨询,还是风险表达。只有进入咨询或风险链路时,skills 才会参与回复生成。
这些 skill 全部放在 skills/*/SKILL.md 里。每个文件都有 name、description 和 Workflow。运行时由 MindBridgeSkillRegistry 扫描加载,并做基础校验,比如是否缺 frontmatter,是否缺 Workflow,目录名和 skill 名是否一致。系统还会把这些状态暴露到 /api/agent/status,管理员可以看到每个 skill 是 READY、WARN 还是 FAILED。这让 skill 不再只是几段散落在 prompt 里的文字,而是可以检查、可以测试、可以维护的项目资产。
[!NOTE] skills具体介绍
- supportive_response_baseline 是所有心理咨询回复的底线规则。它要求模型先回应学生具体感受,不做诊断,不给药物建议,不输出后台风险等级,也不把话说成报告口吻。它还限制回复不要变成很长的清单,一次给一两个可执行步骤就够了。这个 skill 解决的是学生端回复的基本口吻问题:温和、具体、不评判,同时不越过心理咨询和医疗边界。
- referral_resource_guidance 负责转介建议。它会提醒模型把求助说成现实可行的下一步,而不是把它包装成“你不够坚强”。它允许提到学校心理中心、辅导员、可信任老师、室友、家人、校园安保或当地紧急资源,但禁止编造电话号码、办公时间、老师姓名和学校政策。也就是说,知识库没有提供的信息,模型不能硬编。
- anxiety_grounding_support 用在焦虑、惊恐、崩溃、呼吸紧张、脑子停不下来这类表达里。它不会把学生诊断成焦虑症,而是让模型先承认这种体验很难受,再给一个简单的稳定动作,比如慢一点呼吸、看见并说出五个物体、双脚踩地。它的重点不是讲大道理,而是先让学生从一整团压力里退出来,抓住下一件小事。
- sleep_routine_support 用在失眠、睡不着、熬夜、作息乱这些场景。它提醒模型不要给药物、补剂或治疗方案,也不要用“你应该早睡”这种带责备感的话。它更适合给今晚能做的小安排,比如减少刺激、把担心的事写下来、准备明天第一步、做一个安静活动。如果睡眠问题持续一到两周,或已经影响安全和日常功能,回复里会建议学生联系校园支持资源。
- academic_stress_planning 面向考试、挂科、绩点、论文、作业和学业压力。它会把“我完蛋了”这种大压力拆成更小的动作:选一个具体任务,定一个时间块,设一个现实的停止点。它不把成绩和人的价值绑在一起,也不靠口号鼓励学生硬扛。如果压力已经超过一个人能处理的范围,它会引导学生去找老师、导师、同学、辅导员或校内学业支持渠道。
- high_risk_safety_plan 是最敏感的一个 skill。只要系统判断为高风险,回复就会优先处理当前安全,而不是继续做情绪分析。它要求模型使用短句,鼓励学生马上联系身边可信任的人、辅导员、心理中心、校园安保或当地紧急救助;同时提醒学生不要独处,离开可能增加危险的物品、地点或条件。它也明确禁止提供自伤、自杀方法、工具细节或危险操作步骤。这个 skill 的目的很直接:先把接下来 10 到 15 分钟变得更安全。
- counselor_handoff_summary 和前面几个不一样。它不是给学生看的,而是给辅导员或管理员看的交接摘要模板。报告生成后,系统会把报告 ID、学生身份、风险等级、情绪标签、置信度、模型摘要、建议跟进动作和学生原始表达摘录渲染成一段工作人员能接手的文本。学生端要温和克制,后台交接要事实清楚,这两个语气必须分开。
十七、评测与验收
1. RAG 评测
指标:
- Recall@K
- Precision@K
- MRR
- NDCG@K
- HitRate
2. 工程 Harness
运行:
python3 -m app.harness.runner --json
[!NOTE] 覆盖
- Risk Safety Harness:高风险识别、报告生成、后台元数据不外显、工具队列入队。
- Agent Routing Harness:验证 CHAT / CONSULT / RISK 路由和 Agent 步骤。
- RAG Harness:验证知识库召回指标。
- API Harness:健康检查、认证授权、SSE、管理员知识库接口。
- Tool Queue Harness:Excel、case、alert 依赖、幂等、限流和 dead letter。
3. 当前验收结果
最近一次本地 harness 结果:
passed=true
totalCases=60
topK=4
Recall@K=0.9667
Precision@K=0.6458
MRR=0.9083
NDCG@K=0.9053
HitRate=0.9667
十七、代码解读
目录怎么分工
| 路径 | 作用 | 阅读建议 |
|---|---|---|
| app/main.py | 创建 FastAPI 应用,注册启动和关闭逻辑,挂载静态页面 | 第一个看 |
| app/api/ | HTTP 路由、权限依赖和 SSE 对话入口 | 看清系统对外提供什么 |
| app/agents/ | 事件驱动多 Agent 协作、任务认领、共享黑板和单轮运行结果 | 核心代码 |
| app/services/ | AI、记忆、RAG、报告、Skill、工具队列等业务服务 | 代码量最大,也是主要实现区 |
| app/models/ | SQLAlchemy 数据表映射 | 配合业务流程看 |
| app/schemas/ | 请求、响应和内部消息 DTO | 用来确认接口字段 |
| app/knowledge/ | 启动时自动导入的校园心理知识文档 | RAG 的默认语料 |
| app/mcp_tools/ | 对外暴露 Excel、个案和预警工具的 MCP 服务 | 工具队列关闭时仍可复用 |
| app/rag_eval/ | RAG 评测数据和指标计算 | 检查检索质量 |
| app/risk_eval/ | LOW、MEDIUM、HIGH 三分类评测 | 检查风险识别 |
| app/harness/ | 使用 mock AI、临时数据库和内存替身跑端到端工程检查 | 比普通单测更接近完整业务链 |
| app/static/ | 登录页、学生页、管理员页及原生 JavaScript | 无前端框架 |
| skills/ | 运行时加载的标准心理支持 Skill | 约束模型如何回答不同场景 |
| tests/ | unittest 回归测试 | 覆盖协议、记忆、脱敏、风险和工具策略 |
| scripts/ | 开发启动、Ollama 模型创建和发布打包 | 主要面向 Linux 或 macOS shell |
整体结构
flowchart TD
    UI["学生端或管理员端"] --> API["FastAPI 路由"]
    API --> CHAT["ChatService"]
    CHAT --> HARNESS["MindBridgeAgentHarness"]
    HARNESS --> RUNTIME["EventDrivenAgentRuntimeService"]
    RUNTIME --> BOARD["任务板与共享黑板"]
    BOARD --> UA["UnderstandingAgent"]
    BOARD --> SA["SafetyAgent"]
    BOARD --> CA["ContextAgent"]
    BOARD --> RA["ResponseAgent"]
    CA --> REDIS["Redis 短期记忆"]
    CA --> RAG["Chroma 与 BM25 检索"]
    CA --> SKILL["skills 目录"]
    HARNESS --> MYSQL["MySQL 业务数据与 trace"]
    CHAT --> LLM["Ollama、OpenAI 或 mock"]
    HARNESS --> QUEUE["异步工具队列"]
    QUEUE --> EXCEL["Excel 台账"]
    QUEUE --> CASE["风险个案"]
    QUEUE --> ALERT["日志或 SMTP 预警"]
这里有两个容易混淆的层次。app/agents/ 负责一次 Agent 协作怎么得出回复方案,MindBridgeAgentHarness 负责这轮业务怎么落库、建报告、记 trace 和安排后续工具。HTTP 路由没有直接拼这些步骤。
应用如何启动
入口是 app/main.py。模块加载时会执行 create_app(),随后把结果赋给 app,所以开发命令可以直接使用 uvicorn app.main:app。
启动阶段做三件事:
- Base.metadata.create_all() 创建缺失的数据表。
- seed_data() 在空库中写入演示管理员和学生账号,同时把 app/knowledge/*.md 切块并同步到知识库。
- 启动 ToolQueueWorker,轮询数据库里的待执行工具任务。 关闭应用时,后台工具线程会收到停止信号,两个线程池也会停止接收新任务。
静态目录最后挂载到 /。因为 API 路由先注册,/api/... 和 /actuator/health 仍由 FastAPI 路由处理,其他路径交给静态文件服务。
配置集中在 app/core/config.py,使用 pydantic-settings 从环境变量和 .env 读取。默认数据库是 MySQL,默认短期记忆是 Redis,默认模型提供方是 Ollama。docker-compose.yml 会启动 MySQL 8.0、Redis 7.2 和应用容器,应用镜像使用 Python 3.12。
项目没有数据库迁移工具。create_all() 只能补建缺失表,不能可靠处理已有表的字段变更。表结构继续演进时,应该补 Alembic 一类的迁移方案。
一条学生消息怎么走
学生页面向 POST /api/chat/stream 发送 message 和可选的 sessionId。管理员账号会被这个接口拒绝。
1. 路由进入 ChatService
app/api/routes.py 完成 Basic Auth 和角色检查,然后创建 ChatService。接口返回 StreamingResponse,事件格式是 SSE。
app/services/chat.py 先同步执行 harness,拿到模型所需的消息列表,然后依次发送:
meta  -> 返回 sessionId
token -> 持续返回模型文本片段
done  -> 本轮结束
模型输出拼接完成后,助手消息会写入 MySQL 和 Redis。报告相关工具在回复结束后调度,工具失败只记日志,不会把已经生成的学生回复改成失败。
2. harness 准备输入和业务上下文
app/agents/harness.py 是单轮业务编排中心。它会:
- 保留原始输入,同时生成供模型使用的脱敏输入。
- 根据 sessionId 找旧会话,或者创建新会话。
- 调用事件驱动 Agent runtime。
- 保存学生消息。
- 对 CONSULT 和 RISK 意图创建心理报告。
- 保存本轮 trace。
- 生成后置工具计划。 普通 CHAT 不创建心理报告。AgentRunResult.requires_report 的判断条件是意图不等于 CHAT。
3. runtime 组织多 Agent 协作
app/agents/event_driven_runtime.py 先创建一块新的 CollaborationBlackboard,再把四个工作 Agent 注册到 AgentRegistry。CoordinatorAgent 不参与普通任务认领,它负责创建根任务、维护预算和决定是否接纳最终方案。
共享黑板里有四类信息:
| 类型 | 内容 |
|---|---|
| task | 待理解、待评估、待取上下文、待回复或待复审的工作 |
| message | Agent 之间的定向消息或广播 |
| artifact | 意图、风险、上下文、回复方案、审查意见 |
| event | 任务创建、认领、关闭、发布 artifact、触发安全覆盖等轨迹 |
CollaborationBlackboard 使用冻结 dataclass。新增事件或 artifact 会返回新对象,旧对象不被原地改写。task 的状态仍会通过复制后的新字典更新,所以 "append-only" 主要适用于事件、消息和 artifact 历史,不代表任务永远不变。
4. 各 Agent 做什么
| Agent | 输入和职责 | 主要产物 |
|---|---|---|
| UnderstandingAgent | 结合硬规则和模型判断 CHAT、CONSULT、RISK | intent artifact |
| SafetyAgent | 独立评估 LOW、MEDIUM、HIGH,并审查回复方案 | risk、safety_review 或 critique |
| ContextAgent | 读取短期记忆,压缩历史,改写查询,调用 RAG,选择 Skill | context artifact |
| ResponseAgent | 把意图、风险、知识、Skill 和历史组合成模型 prompt | response_proposal artifact |
| CoordinatorAgent | 派生缺失任务,限制轮次和认领次数,检查接纳条件 | FINAL_ACCEPTED event |
它叫 "事件驱动多 Agent",因为工作来自开放任务和能力匹配,不是写死的函数链。当前实现仍在一个进程、一个请求线程内按顺序调用各 Agent 的 act()。同一轮可以选出多个候选,但代码没有并发执行它们,因此这里的 "多 Agent" 描述的是职责和协议隔离,不代表并行计算。
默认最多运行 8 轮,每轮最多认领 4 个任务,每个 Agent 最多认领 3 次。候选先按任务优先级排序,再看认领置信度。高风险任务会获得更高优先级,SafetyAgent 还可以发布 SAFETY_OVERRIDE,把本轮风险强制提升为 HIGH。
5. 最终回复如何生成
ResponseAgent 产出的不是完成后的自然语言答案,而是一组 AiMessage prompt。SafetyAgent 审查的也是这组 prompt。审查通过后,runtime 把 prompt 交还给 ChatService,真正的答案才由 AiClient.stream() 生成并发送给学生。
这意味着当前安全门检查的是 "生成条件",没有检查最终生成文本。高风险 prompt 本身包含安全规则,所以现有审查很容易通过,但模型输出仍可能偏离规则。若要形成完整安全闭环,应先生成候选文本,再让安全审查读取实际文本;审查不通过时重新生成,最后只流式发送通过审查的版本。这样做会增加首字延迟,需要在安全性和实时体验之间做明确选择。
意图和风险判断
意图分类在 app/services/ai.py 和 UnderstandingAgent 中实现。代码先查硬编码词表。普通编程、作业、校园事务等词倾向 CHAT,焦虑、压力、失眠等词倾向 CONSULT,自杀、自残和即时危险表达直接进入 RISK。
风险评估由 app/services/assessment.py 完成:
- 高风险关键词先走硬保护,不调用模型,直接返回 HIGH 和 0.95 置信度。
- 其他输入请求模型输出严格 JSON。
- 解析成功后,风险等级还会和情绪分数互相校正,只允许向更高风险升级。
- 模型异常或 JSON 解析失败时,回退到本地启发式规则。 这种做法能保证明确关键词不被模型漏掉,但词表判断缺少语境。比如引用一句高风险表达进行新闻讨论,也可能触发 HIGH;没有出现词表中的隐晦表达则可能漏过。仓库提供 100 条 JSONL 风险评测集和三分类指标,后续调整词表或 prompt 时应同时检查高风险召回率、漏报率和误报率。
记忆和隐私
长期聊天记录写入 MySQL 的 chat_sessions 和 chat_messages。Redis 只保存最近若干条消息,并设置 TTL。Redis 不可用时,系统记录警告并回退到 MySQL;从 MySQL 读到历史后还会尝试回填 Redis。
历史过长时,app/services/memory.py 会保留最近消息,并在前面放一条仅供内部使用的摘要。摘要限制长度,也明确要求模型不要向学生暴露诊断、风险等级或后台标签。各 Agent 还有单独的 Redis key,用来保存自己的意图历史、安全台账、上下文记录或回复策略。
PrivacySanitizer 目前识别手机号、邮箱和 18 位身份证号。脱敏后的文本用于模型输入和 Redis 记忆,但原始内容仍会写入这些位置:
- chat_messages.content
- psychological_reports.content
- agent_run_traces.original_input 因此当前设计是 "减少模型和缓存侧暴露",不是全链路匿名化。管理员还可以通过后台接口查看完整会话和原始 trace。若项目处理真实学生数据,需要补数据最小化、字段加密、访问审计、保留期限和删除流程,不能只依赖三个正则表达式。
RAG 怎么工作
app/services/knowledge.py 负责文档切块、入库、召回、融合和重排。启动时,app/knowledge/*.md 会按字符长度切块,相邻块保留重叠区域。管理员也可以上传 UTF-8 文本或 PDF。
主检索路径分成几步:
- 使用 OpenAI embeddings 接口生成向量,并在 Chroma 中取语义候选。
- 对 MySQL 中的全部知识块计算本地 BM25,取关键词候选。
- 分别归一化两组分数,按默认的 0.65 和 0.35 权重融合。
- 使用词项余弦、查询覆盖率和短语命中做本地重排。
- 对排名第一的块补上同源的前后相邻块,减少切块造成的断句。 没有 OPENAI_API_KEY、缺少 Chroma,或者向量调用失败时,系统回退到 BM25 和本地词面重排。若 KNOWLEDGE_VECTOR_REQUIRED=true,同样的故障会直接抛错。
这里要注意一处配置落差。docker-compose.yml 传入了 OLLAMA_EMBEDDING_MODEL,但 Settings 没有这个字段,向量实现也只调用 OpenAI-compatible /embeddings。由于配置允许忽略多余字段,这个环境变量不会生效。若计划使用 Ollama embedding,需要补配置字段和对应客户端实现。
Chroma 每次 upsert 后都会复制持久化目录做快照,并只保留最近若干份。知识库较大或更新频繁时,这会产生明显磁盘开销。
Skill 系统
app/services/skills.py 扫描 skills/*/SKILL.md,解析简单的 YAML frontmatter,并对目录名、描述长度、## Workflow 小节和交接模板做校验。
运行时的选择规则比较直接:
- CHAT 不加载心理支持 Skill。
- HIGH 固定加载基础支持和高风险安全计划。
- 普通 CONSULT 默认加载基础支持和转介资源,再根据焦虑、睡眠或学业关键词追加专用 Skill。
- counselor_handoff_summary 不进入学生 prompt,它用于生成管理员和辅导员看的个案交接摘要。 这套系统本质上是 "文件化 prompt 规则",还不是可以自行执行工具的通用 Skill runtime。优点是容易审阅和版本管理,限制是触发逻辑主要靠关键词,Skill 之间也没有复杂的优先级与冲突处理。
报告、工具队列和 MCP
CONSULT 或 RISK 轮次会创建 PsychologicalReport。之后的工具计划取决于报告风险:
LOW    -> EXCEL_REPORT
MEDIUM -> EXCEL_REPORT + CASE_CREATE
HIGH   -> EXCEL_REPORT + CASE_CREATE -> ALERT_SEND
app/services/tool_queue.py 把任务写进 tool_jobs,后台线程轮询后交给两个线程池。Excel 和建个案使用一个线程池,预警使用另一个线程池。预警任务会等待个案创建成功,还受到每分钟发送次数限制。执行失败后按次数重试,超过上限写入 dead_letter_records。
工具实现位于 app/services/tools.py:
- Excel 使用进程内锁串行写入,并通过成功记录避免正常重试时重复写入。
- 中高风险报告会创建或复用 RiskCase。
- 高风险个案可以使用日志模式模拟预警,也可以通过 SMTP 发邮件。
- 管理人员可以确认接手个案并追加跟进备注。 app/mcp_tools/server.py 把同一组业务操作暴露为 MCP 工具。默认启用队列时,应用直接调用本地业务服务;关闭队列后,MindBridgeMcpToolClient 会通过 stdio 启动 MCP server 并调用工具。
仓库还定义了 ToolPolicyRegistry 和 ToolGovernanceService,用于按风险等级授权工具并记录 tool_audit_records。但当前 ToolQueueWorker 只导入了 ToolGovernanceService,实际执行路径没有调用 start_job()、require_allowed() 或 finish()。MCP 路径也没有接这层治理。也就是说,策略单测验证了授权函数本身,生产执行链却没有强制经过它,管理员的工具审计列表通常也不会产生对应记录。这是需要优先补上的接线问题。
工具幂等也有一个小窗口。Excel 文件先保存,数据库成功记录随后提交。如果进程恰好在两步之间退出,重试可能再次追加同一报告。生产实现可以在表中加入业务唯一约束,并让文件写入和任务状态使用更明确的幂等键。
数据表在保存什么
app/models/entities.py 中的表大致分为五组:
| 分组 | 表 |
|---|---|
| 用户与会话 | user_accounts、chat_sessions、chat_messages |
| 知识库 | knowledge_chunks |
| 心理支持记录 | psychological_reports、risk_cases、case_notes |
| 工具执行 | excel_records、alert_records、tool_jobs、dead_letter_records、tool_audit_records |
| 可观测性 | agent_run_traces |
agent_run_traces 保存原始输入、脱敏输入、记忆摘要、Agent 步骤、检索结果、回复 prompt 和评估结果。它便于复盘,但也集中保存了敏感内容。trace 的读权限、保留时长和导出范围应该比普通运营数据更严格。
前端做了什么
前端没有 React 或 Vue,三个页面都使用原生 HTML、CSS 和 JavaScript。
index.html 与 app.js 负责登录。用户名和密码被编码成 Basic Auth token,连同账号信息放在 sessionStorage。学生页读取 SSE 流并增量更新对话气泡;管理员页并行拉取报告、个案、Excel 记录和预警记录,在浏览器中计算趋势和分布,还提供知识文件上传、向量重建和快照按钮。
Basic Auth 配合 SHA-256 单次哈希只适合本地演示。密码哈希没有盐,也没有慢哈希成本;浏览器端还保存了可逆的 username:password 编码。真实部署应使用 TLS、Argon2 或 bcrypt、短期会话或 token,并加入登录限流和审计。
测试和评测
tests/ 使用标准库 unittest,当前有 18 个测试,覆盖:
- 共享黑板的不可变更新和 artifact 保留
- Agent 按置信度认领任务
- Agent 单独配置模型
- 记忆压缩和隐私脱敏
- 高风险硬保护先于模型调用
- Skill 解析和校验
- 工具风险策略
- 三分类风险指标 在本仓库的 Windows Python 3.10 虚拟环境中,使用内存 SQLite 运行以下命令,18 个测试全部通过:
$env:DATABASE_URL='sqlite:///:memory:'
.\.venv-win\Scripts\python.exe -m unittest discover -s tests
直接使用系统 Python 3.8 无法运行本项目,因为环境缺少 pydantic-settings,SQLAlchemy 版本也不符合 2.x API。现有 Windows 虚拟环境还缺少 pymysql,所以不覆盖默认 MySQL 连接。单测通过只能说明这些隔离逻辑符合当前断言,不能证明 MySQL、Redis、Chroma、SMTP、真实模型和浏览器链路已经一起通过。
更完整的检查入口是 python -m app.harness.runner。它包含风险安全、Agent 路由、标准 Skill、RAG、API 和工具队列六组工程检查,并把报告写到 target/harness/。RAG 评测会计算 Recall@K、MRR、NDCG 和 HitRate;风险评测会输出混淆矩阵和高风险相关指标。
十八、高频面试问答
这个项目为什么要用多 Agent?
因为校园心理场景里,一轮请求不是简单问答。系统至少要做意图理解、风险识别、上下文读取、知识检索、回复规划和安全审查。如果都塞进一个 prompt,逻辑会很混乱,也不方便观测。
当前默认实现是事件驱动多 Agent:CoordinatorAgent 维护任务板,UnderstandingAgent 判断意图,SafetyAgent 评估风险和审查回复,ContextAgent 按需聚合记忆、RAG 和 skill,ResponseAgent 生成候选回复 prompt。这样高风险场景一定会经过独立安全评估和回复安全审查,调试和追踪也更清楚。
Chroma 不可用怎么办?
系统不是强依赖 Chroma。如果没有 OPENAI_API_KEY、缺少 chromadb 或 embedding 调用失败,会自动降级到本地 BM25 和 hybrid_score reranker。
RAG 里你自己实现了什么?
除了接入 Chroma,我自己实现了文本切块、BM25 评分、中文 tokenization、向量分数和 BM25 分数归一化、权重融合、本地 reranker、query 覆盖率、短语命中评分和最佳 chunk 上下文扩展。
还有RAG测评
高风险怎么识别?
先用高风险词库硬规则识别,例如自杀、自残、不想活、kill myself 等。没有命中时,调用模型输出严格 JSON,包括 emotion、emotionScore、risk、confidence 和 summary。如果模型异常或 JSON 解析失败,就用关键词规则兜底。高风险场景最终会强制 risk 为 HIGH。
会不会把风险等级告诉学生
不会。学生端回复 prompt 明确要求不输出风险等级、报告分数、后台标签或诊断结论。风险等级只给后台报告、个案和预警使用。学生端只看到共情、安全建议和求助引导。
如果 Redis 挂了怎么办?
RedisShortTermMemoryStore 连接失败或读写失败时会记录 warning,然后返回空历史。系统仍然能从 MySQL 回填最近消息,聊天不会因为 Redis 异常直接中断,只是短期记忆速度和连续性会受影响。
SSE 为什么不用 WebSocket?
这个场景主要是服务器向浏览器单向推送模型 token,不需要复杂的双向实时协议。SSE 基于 HTTP,浏览器支持好,开发成本低,适合大模型文本流式输出。WebSocket 更适合多人协作、实时控制或复杂双向交互。
工具调用为什么不直接同步执行?
Excel 写入、创建个案、邮件预警都不是学生端首 token 的必要条件。同步执行会拉长响应时间,甚至因为 SMTP 慢或失败影响学生体验。所以系统默认把工具任务写入 tool_jobs,由后台 worker 异步处理,并支持重试和 dead letter。
MCP 在项目里起什么作用?
MCP 把 Excel、个案和预警能力包装成标准工具,后端可以通过 MCP client 调用同一套工具服务。这样工具能力和聊天主流程解耦,后续如果要接入其他 Agent 或外部客户端,也可以复用这些工具。
为什么有工具队列后还保留 MCP?
工具队列解决的是异步、依赖、限流、重试和死信,MCP 解决的是工具协议和标准化调用。默认情况下,后端通过队列复用同一套工具实现,关闭队列后,也可以通过 MCP client 直接 stdio 启动 MCP server 调用工具。
多个学生同时触发 Excel 写入会冲突吗?
同一 Python 进程内,Excel 写入使用 threading.Lock 串行化,避免 openpyxl 同时写同一个文件造成损坏。多进程或多实例部署时,建议把 Excel 改成后台定时导出,或者用数据库作为主台账,再加分布式锁。
邮件发送失败怎么发现?
邮件发送会写入 alert_records,状态为 SUCCESS 或 FAILED。如果通过工具队列发送失败,任务会记录 last_error,按配置重试;超过最大次数后进入 dead_letter_records,管理员可以通过后台接口查看。
权限隔离怎么做?
使用 Basic Auth 登录后得到当前用户。管理员接口依赖 require_admin,必须包含 ROLE_ADMIN。学生聊天接口会拒绝管理员账号。学生侧操作从登录态获取用户 ID,不允许前端传用户 ID 来查别人的数据。
怎么证明 RAG 有效果?
项目提供 app/rag_eval/runner.py 和评测数据集,指标包括 Recall@K、Precision@K、MRR、NDCG@K 和 HitRate。当前本地 harness 的 RAG 数据集 60 条,Recall@K 和 HitRate 都是 0.9667,说明大多数问题能在 topK 里召回预期知识。
你遇到的技术难点是什么?
一个难点是心理安全场景不能只依赖模型自由生成,所以做了高风险词库、模型 JSON 评估和关键词兜底三层风险识别,并且学生端不暴露后台标签。另一个难点是 RAG 在无向量环境下也要可用,所以做了 Chroma 主链路和 BM25 本地降级。第三个难点是工具调用不能阻塞流式回复,所以加了工具队列、依赖调度、限流、重试和死信。
如果让你继续优化,会怎么做?
可以从四个方向优化:
- RAG 切块从固定长度升级为 Markdown 标题、政策条款和语义段落切块。
- 引入专门的 rerank 模型或 LLM rerank,提高复杂问题的排序质量。
- 把 Excel 台账改成数据库主记录加导出任务,更适合多实例生产部署。
- 加入更细粒度的审计、告警确认流转、管理员操作权限和敏感数据加密。
当前项目最适合怎么展示?
建议按这条主线展示:
启动服务
-> 学生普通问题,展示 CompanionAgent 不查 RAG
-> 学生焦虑/失眠问题,展示 CONSULT、RAG 和报告
-> 学生高风险表达,展示 HIGH 风险、安全回复、个案、Excel 和预警记录
-> 管理员后台查看 reports/cases/tool-jobs/dead-letters
-> 跑 harness 展示工程验收和 RAG 指标
Agent Harness 架构解决了什么问题?
MindBridgeAgentHarness 解决的是 HTTP 层、Agent Runtime、数据库、工具计划之间的耦合问题。HTTP 层只负责认证和 SSE,runtime 只负责多 Agent 推理,harness 统一编排输入脱敏、会话解析、Agent run、报告落库、工具计划、消息保存和 trace 输出。这样核心链路可以不依赖真实 HTTP 请求做自动化验收。
为什么不直接在 ChatService 里写所有逻辑?
如果把脱敏、查会话、跑 Agent、写报告、调工具全放在 ChatService,这个类会变成大而全的业务入口,后面很难测试。拆出 harness 后,ChatService 只管 SSE 流式输出,harness 管一轮业务闭环,Agent runtime 管决策链路,职责更清晰。
Harness 和 Agent Runtime 的边界是什么?
Agent Runtime 只关心“给定用户、会话和模型输入,产出 intent、risk、knowledge、response messages 和 steps”。Harness 关心“这一轮请求怎么进入系统、结果怎么落库、是否生成报告、是否调工具”。一句话,runtime 做推理编排,harness 做业务编排。
Engineering Harness 和 Agent Harness 是一个东西吗?
不是。MindBridgeAgentHarness 是线上业务链路的一部分;app.harness.runner 是工程验收工具。工程 harness 会用 mock AI、临时 SQLite、内存记忆去跑风险安全、路由、RAG、API 和工具队列,验证系统行为是否符合预期。
为什么要专门做 Engineering Harness?
这个项目涉及心理安全,不能只靠手工点页面。Engineering Harness 可以把高风险识别、后台标签不外显、Agent 路由、知识库召回、工具任务依赖和 dead letter 都自动跑一遍,保证改代码后核心安全链路没有回归。
Harness 为什么用 mock AI?
mock AI 的输出稳定、便宜、可重复,不依赖 Ollama、OpenAI 或网络。它适合做工程行为验证,比如某类输入是否路由到 RISK,是否生成报告,是否创建工具任务。真实模型效果可以单独做人工测试和模型评估。
Engineering Harness 覆盖哪些测试套件?
当前包括五类:Risk Safety Harness、Agent Routing Harness、RAG Harness、API Harness 和 Tool Queue Harness。它们分别验证风险安全、Agent 路由、知识库召回、接口认证/SSE、工具队列依赖与失败处理。
Risk Safety Harness 主要验证什么?
它会构造中文高风险、英文高风险、普通咨询和普通聊天四类输入。高风险必须生成报告并入队 alert,普通咨询生成报告但不一定发 alert,普通聊天不生成心理报告。同时还会检查学生端回复不暴露 HIGH_RISK、风险等级、报告 ID 等后台元数据。
Tool Queue Harness 主要验证什么?
它验证一条高风险报告会生成 Excel 任务、个案任务和预警任务,并且预警任务依赖个案创建成功。它也会验证任务失败后的 dead letter 记录,说明队列不是只做了 happy path。
API Harness 主要验证什么?
它用 FastAPI TestClient 验证健康检查、Basic Auth、SSE 聊天、管理员知识库接口等 API 行为,确保路由层和权限层没有明显回归。
App-level skills 和 MCP tools 有什么区别?
Skills 是模型回复或后台摘要的行为指引,比如高风险安全计划和辅导员交接摘要;MCP tools 是可执行工具,比如写 Excel、创建个案、发送预警。一个偏 prompt policy,一个偏外部动作。
为什么 high_risk_safety_plan 要做成 skill?
高风险回复要求非常稳定:不能输出危险细节,要鼓励联系现实支持,要优先确认安全。把这类要求沉淀成 skill,可以复用、审计和测试,避免每个 prompt 临时手写造成遗漏。
counselor_handoff_summary 解决什么问题?
它把心理报告转换成辅导员能直接接手的结构化摘要,包括学生、风险等级、情绪标签、置信度、模型摘要、建议跟进动作和原始表达。这样管理员看到的不只是一个风险等级,而是能继续处理的个案信息。
Skills 会不会和 RAG 知识冲突?
不会。RAG 提供校园心理知识和流程依据;skills 提供高风险回复策略和交接摘要格式。RAG 回答“依据是什么”,skills 约束“应该怎么安全地表达和交接”。
为什么高风险时不让模型自由发挥?
心理危机场景里,模型自由发挥可能出现危险建议、过度承诺保密、诊断化语言或忽略现实救助。项目通过高风险词库、风险评估、high_risk_safety_plan 和系统 prompt 共同约束输出,降低安全风险。
当前 high_risk_safety_plan 具体约束了哪些点?
它要求模型先确认痛苦、不争辩不诊断;强调当前安全;鼓励联系可信任的人、辅导员、心理中心、校园保卫或紧急服务;建议不要独处并远离危险物品;只追问一个和当前安全相关的问题;不输出危险操作细节。
为什么需要辅导员交接摘要?
高风险识别只是第一步,后续必须有人跟进。交接摘要能帮助辅导员快速知道报告 ID、学生、风险、置信度、摘要和建议动作,减少人工从长对话里翻找重点的时间。
当前项目怎么保证学生端不看到后台报告?
报告生成发生在 harness 后台逻辑里,学生端流式回复只来自 response_messages 的模型输出。系统 prompt 明确禁止输出风险等级和分数,Risk Safety Harness 也会检查回复里没有后台元数据。
为什么报告只在 CONSULT / RISK 生成?
普通聊天不应该被心理化记录,否则会产生大量无意义报告,也会增加隐私负担。只有心理咨询和风险场景才需要后台记录情绪、风险、置信度和摘要。
requires_report 是怎么判断的?
AgentRunResult.requires_report 返回 intent != CHAT。也就是说 CONSULT 和 RISK 会进入报告落库,普通 CHAT 不生成心理报告。
如果模型 JSON 格式乱了怎么办?
PsychologicalAssessmentService 会尝试截取 JSON 对象并解析。如果解析失败或模型调用异常,就进入 heuristic 规则,根据关键词返回焦虑、低落或正常等兜底评估。
你们怎么处理英文高风险表达?
高风险词库包含英文表达,比如 suicide、kill myself、self harm。Engineering Harness 里也有英文高风险用例,验证英文高风险能生成报告并触发 alert 任务。
为什么 Redis 里保存的是脱敏内容?
Redis 是短期上下文缓存,进入模型前和缓存读取时都会经过 PrivacySanitizer。这样可以减少手机号、学号、身份证号等敏感信息被重复送入模型或缓存的风险。
MySQL 里保存原文会不会有隐私问题?
MySQL 保存完整消息是为了审计和管理员复盘,但这也意味着生产环境需要进一步做字段级加密、访问审计、数据留存策略和删除机制。当前项目是原型实现,文档里没有把它包装成完整合规系统。
为什么 Redis 失效后要从 MySQL 回填?
Redis 是缓存,可能过期或不可用。如果直接丢失上下文,多轮对话体验会变差。MySQL 保存完整历史,Redis miss 时从 MySQL 最近消息回填,可以兼顾性能和连续性。
为什么 chat_history_limit 和 redis_memory_max_messages 是两个配置?
redis_memory_max_messages 控制 Redis 保存多少短期消息,chat_history_limit 控制真正进入模型的历史窗口。前者偏缓存容量,后者偏模型上下文长度控制。
Chroma 的 embedding 存在哪里?
Chroma 的持久化目录由 CHROMA_PERSIST_DIR 配置,默认是 data/chroma。同时每个 KnowledgeChunk 的 embedding JSON 会保存到数据库字段里,方便复用和减少重复 embedding。
为什么要做 Chroma 快照?
向量库是知识检索链路的重要资产。backup_vector_index 会把 Chroma 持久化目录复制到 CHROMA_SNAPSHOT_DIR,并按 CHROMA_SNAPSHOT_KEEP 保留最近快照,方便回滚和交付备份。
为什么 BM25 还要保留?
心理知识库里很多问题包含明确关键词,比如“失眠”“惊恐”“辅导员”“心理中心”。BM25 对关键词命中很敏感,可以补充向量检索的语义召回,也能在向量服务不可用时作为兜底。
为什么要融合向量分数和 BM25 分数?
向量检索擅长语义相似,BM25 擅长关键词精确匹配。融合后可以兼顾“意思相近”和“关键词命中”。项目里先归一化两个分数,再按配置权重计算融合分。
RAG 评测的 HitRate 和 Recall@K 有什么区别?
在当前评测实现里,每条 case 只要 topK 里出现相关结果,hit=true,recallAtK=1.0,否则为 0。所以平均 HitRate 和 Recall@K 很接近。更复杂的数据集如果有多个相关文档,可以扩展成真正多相关项 recall。
Precision@K 为什么比 Recall@K 低?
因为 topK 返回 4 条,只要其中一条相关,Recall@K 就算命中,但 Precision@K 会统计 4 条里相关结果占比。心理知识库小而主题相近,常见情况是第一条相关,后面几条部分相关或不相关,所以 Precision@K 会低一些。
MRR 说明什么?
MRR 看第一条相关结果的排名。当前 MRR 为 0.9083,说明多数问题的第一条相关结果排得比较靠前,对生成回答比较友好。
NDCG@K 说明什么?
NDCG@K 衡量相关结果在排序里的位置质量。值越高,说明相关结果越靠前。当前 NDCG@K 为 0.9053,说明排序质量较好。
为什么工具任务要有依赖关系?
高风险预警最好依赖风险个案创建成功,因为邮件或 log 里需要 caseId,辅导员后续也要围绕个案跟进。如果个案没创建成功就发预警,会造成后台记录不完整。
为什么 ALERT_SEND 需要限流?
如果短时间内大量高风险报告触发邮件,可能压垮 SMTP 服务或被邮件服务限流。项目用 RateLimiter 控制每分钟预警数量,超过后重新入队延迟执行。
dead letter 有什么用?
任务超过最大重试次数后不能无限重试,否则会一直消耗资源。写入 dead letter 后,管理员可以看到失败原因和 payload,后续人工修复配置或数据后再处理。
服务重启时 RUNNING 任务怎么办?
ToolQueueWorker.start 会调用 _recover_running_jobs,把重启前卡在 RUNNING 的任务恢复成 PENDING,避免任务因为进程退出永远停留在运行中。
为什么 Excel 任务和邮件任务用不同线程池?
Excel 写入是文件 I/O,邮件发送可能受网络和 SMTP 影响。分开线程池可以避免邮件阻塞影响 Excel,也便于分别配置 worker 数量和限流策略。
为什么 Excel worker 默认是 1?
当前 Excel 是单文件追加写入,同一进程内需要串行化,默认 1 个 worker 更安全。邮件可以并发发送,所以 email worker 默认是 2。
如果多实例部署,当前工具队列有什么问题?
当前工具队列基于数据库轮询和进程内线程池,单实例演示没问题。多实例部署时需要更严格的任务抢占锁、幂等控制和分布式锁,或者迁移到 Celery、Redis Stream、RabbitMQ 这类队列系统。
为什么权限没有做 JWT?
当前项目定位是演示和交付验证,Basic Auth 足够简单,便于 curl 和本地测试。生产环境可以升级为 JWT、Session、OAuth 或学校统一身份认证,并加入密码策略和审计。
你怎么向面试官突出这个项目不是简单套壳?
大家可以从以下五点讲,第一,有 Agent Harness 把 HTTP、Agent、落库、工具计划解耦。第二,有多 Agent 动态路由,不同意图走不同链路。第三,RAG 自己实现了 BM25、融合排序、本地 reranker 和降级。第四,高风险场景有词库、模型 JSON、skills 和后台报告闭环。第五,有 Engineering Harness 自动化验证风险安全、路由、RAG、API 和工具队列。
十九、项目面经(持续更新)
腾讯一面(来源我自己找第二段实习的面经,已oc,6.29)
- 介绍一下下面这个项目,用了哪些技术栈然后完整链路是怎样的 技术栈简历描述那里写了这里我就不再赘述
完整链路是:
学生调用 /api/chat/stream -> ChatService -> MindBridgeAgentHarness 做输入脱敏、session 解析 -> 事件驱动多 Agent runtime 产出 intent/risk/context/response prompt -> SSE 流式调用模型输出 -> 保存助手消息 -> 如果有心理报告则异步入队工具任务 -> 写 Excel、建风险个案、发预警。
- MindBridgeAgentHarness在这个项目里有什么作用呢,为什么要这么设计 MindBridgeAgentHarness 是一轮 Agent run 的业务外壳。它不负责具体 Agent 智能协作,而是统一做输入脱敏、创建/查找会话、调用 runtime、保存用户消息、生成心理报告、保存 Run Trace、生成工具计划、派发工具任务。
这样设计的好处是把 HTTP/SSE 层变薄,把风险报告、trace、工具后处理这些跨切面逻辑集中起来。否则聊天接口里会混杂模型调用、数据库、预警、审计,后面换 runtime 或换前端都会很难维护。
- 多agent协作这块具体是怎么协作的? 核心是黑板 + 任务认领,不是固定workflow。每个 Agent 通过 decide() 判断要不要认领开放任务,再通过 act() 发布 artifact、message、event。CoordinatorAgent 根据任务优先级、claim 置信度、预算和安全审查结果决定是否 FINAL_ACCEPTED。如果 SafetyAgent 不通过候选回复,会发布 critique 并触发修订任务。
CoordinatorAgent 创建任务,UnderstandingAgent 判断 CHAT / CONSULT / RISK,SafetyAgent 独立评估风险并审查回复,ContextAgent 聚合记忆、RAG、Skill,ResponseAgent 生成候选回复 prompt。
- 你刚才讲的这个risk什么的agent它是怎么判断风险的,是基于规则吗还是模型 是混合方案。
第一层是硬规则:出现“自杀、自残、不想活、结束生命、kill myself”等高风险词,直接判 HIGH,不再依赖模型。
第二层是模型 JSON 评估:让模型输出 emotion、emotionScore、risk、confidence、summary。
第三层是保守合并:如果 emotionScore 推导出的风险更高,取更高风险,如果 emotion 是 HIGH_RISK,强制 HIGH。模型失败时还有关键词 heuristic 兜底。
- 上下文注入怎么做的,怎么避免很多的历史消息进模型导致问题 ContextAgent 只有在心理咨询、风险,或中高风险时才加载上下文。普通 CHAT + LOW 不走 RAG。它先读 Redis 最近消息,Redis 没有再从 MySQL 最近消息兜底,然后脱敏、压缩成 memory brief,只保留最近 N 条,并用 chat_history_limit 再限制进模型的历史长度。
RAG 只取 top_k 知识片段,Skill 也是按需选择。所以不是把全量历史塞给模型,而是“摘要 + 最近窗口 + 当前输入 + 少量知识 + Skill 约束”。
- Run Trace怎么保存的,它的保存时机是什么样的 Run Trace 在 MindBridgeAgentHarness.run() 里保存:Agent runtime 跑完、心理报告创建完之后,调用 AgentTraceService.save_run() 写入 agent_run_traces 表。保存内容包括 originalInput、sanitizedInput、memoryBrief、intent、riskLevel、reportId、agent steps、协作 events/tasks/artifacts、RAG 结果、评估 JSON、response prompt messages。
注意它是在 SSE 真正流式输出前保存的,助手最终生成文本是在流式结束后另存为 chat message。
- 高风险预警闭环这块,怎么证明这个闭环真的执行成功了 看数据库证据链。psychological_reports 有 HIGH 报告,tool_jobs 里有 EXCEL_REPORT、CASE_CREATE、ALERT_SEND 且状态 SUCCESS。excel_records 有 SUCCESS 且 Excel 文件有行,risk_cases 状态从 OPEN 到 ALERT_SENT,辅导员确认后变 ACKNOWLEDGED,alert_records 有 SUCCESS
失败则进入 dead_letter_records。工程 harness 里也有 Tool Queue Harness,会验证高风险报告入队、依赖关系、幂等、预警成功、dead letter。
MindBridge 的高风险预警闭环主要包括风险识别、报告生成、个案创建、预警通知和人工跟进五个阶段。首先,学生发送消息后,Agent Runtime 通过 UnderstandingAgent 识别意图,SafetyAgent 进行风险评估;当识别为高风险(HIGH)时,Harness 根据风险评估结果生成 PsychologicalReport 并持久化至 MySQL,同时生成后台工具执行计划。学生端通过 SSE 接收经过安全约束的支持性回复,内部风险等级、评分及后台报告不会直接外显。随后,ChatService 调用 dispatch_tools() 将任务写入 tool_jobs,由 ToolQueueWorker 异步执行:首先通过 EXCEL_REPORT 记录风险台账,再通过 CASE_CREATE 创建 RiskCase 并生成辅导员交接摘要,ALERT_SEND 则依赖个案创建成功后发送或记录预警。工具队列通过幂等、限流、失败重试、死信记录及重启恢复提高执行可靠性。最后,辅导员或管理员通过 alert_ack 确认接手个案,并通过 case_note_add 记录后续处置情况,形成从AI 风险识别 → 报告落库 → 异步预警 → 人工确认 → 持续跟进的业务闭环。整个过程由 Trace 和数据库记录支持追踪与审计。需要注意,当前工具派发位于 SSE 回复之后,若客户端提前断开,仍需通过任务提前持久化等机制进一步保障高风险预警不漏发。
- 项目里面做了哪些Skills,是怎么动态加载的 内置 7 个skills,supportive_response_baseline、high_risk_safety_plan、anxiety_grounding_support、sleep_routine_support、academic_stress_planning、referral_resource_guidance、counselor_handoff_summary。
加载逻辑扫描 skills/*/SKILL.md,读取 YAML frontmatter 和正文。选择逻辑是确定性的,CHAT 不加载,HIGH 只加载 baseline + high_risk,咨询场景再按焦虑、睡眠、学业关键词追加对应 Skill。
- 项目里你怎么保证Skill生产的内容是稳定的,而不是说让模型自由发挥 主要靠四层约束
1、Skill 文件是本地静态 Markdown,不是模型生成
2、加载时校验 name、description、body、模板
3、选择逻辑是规则驱动,不让模型自己挑 Skill
4、counselor_handoff_summary 用固定 text 模板占位渲染。最后还有 SafetyAgent 审查候选回复,高风险回复缺少即时安全指引会被打回修订。
腾讯二面(来源我自己找第二段实习的面经,已oc,7.1)
- 有做过skills调优吗有没有什么心得
-
为什么 Excel 写入、预警发送这些要封成 MCP 工具不直接调用 service 方法 不是因为直接调 service 不行,而是 MCP 把“副作用能力”做成标准工具边界。Excel 写入、case 创建、alert 发送都属于外部副作用,封成工具后有几个好处:
-
调用方不用知道 Excel、SMTP、case 表的细节。
- 以后换成短信、工单、企业微信/飞书,也可以继续注册成工具。
- 工具可以独立运行、独立审计、独立授权。
- 队列路径和 MCP 路径可以复用同一套底层 ToolOrchestrationService,避免两套业务实现。
- 假如回复生成成功但是报告落库和工具生成任务失败了,这一轮 turn 的最终状态如何定义 学生端:回复已经生成并发出,可以算“对话响应成功”。
风险闭环:不能算成功,只能算 backend_degraded 或 risk_workflow_failed。因为高风险场景的完成条件不是“模型说完了”,还包括报告落库、case/alert 任务生成、预警可追踪。
当前代码里报告落库在 SSE 输出前,如果报告创建异常,这轮一般会直接失败;工具派发在回复后,如果失败会记录 warning,学生端仍然 done。更稳的设计是把失败写入 trace 或 dead letter,后续补偿。
- Harness 和 Agent Runtime 的边界怎么定义 Agent Runtime 只负责“智能协作”:理解意图、评估风险、取上下文、生成候选回复、做安全审查,最后返回 AgentRunResult。
Harness 负责“业务编排”:脱敏、session、消息持久化、报告落库、trace 保存、工具计划、队列/MCP 派发。也就是说 Runtime 尽量像一个纯推理引擎,Harness 负责把它接入真实业务系统。
- 用户输入高风险内容Agent Runtime 执行到一半它失败了,Harness 应该保存哪些数据? 至少要保存:
原始输入和脱敏输入。
用户、session、turn id。
已经产生的 partial events/tasks/artifacts。
是否命中了高风险硬规则。
失败阶段和异常信息。
如果已经能判断 HIGH,应该保存最小风险报告或失败 trace。
后续补偿任务或人工介入标记。
当前实现主要在 Runtime 成功返回后保存 trace。面试里可以说:这是我会增强的点,高风险场景应该用 try/finally 保存 partial trace,不能因为中途异常导致审计链断掉。
- 直接 MCP 路径和队列路径都能触发 Excel、case和alert,那怎么保证所有副作用路径都经过同一套 policy? 原则上 policy 不能只放在调用方,因为调用方可能绕过。最稳的位置是副作用服务入口,也就是 Excel、case、alert 真正执行前统一经过 ToolPolicyRegistry / ToolGovernanceService。
当前项目已经有 ToolPolicyRegistry,定义了什么风险等级允许执行什么工具;但如果严格讲,队列和 MCP 路径还可以进一步把 require_allowed() 下沉到 ToolOrchestrationService 或 MCP tool 入口,做到所有路径强制经过同一套 policy。这是很好的可改进点。
- 高风险 alert 失败了进入了dead letter 后谁来恢复 dead letter 不是自动无限重试,而是显式终态。恢复一般由管理员/运维/辅导员后台处理:
先看 dead_letter_records 和 tool_jobs.last_error。
如果是 SMTP 配置、网络、限流等问题,修复配置。
再手动重入队或提供后台“重新投递”按钮。
同时高风险 case 不应等技术恢复,辅导员可以根据 report/case 先人工跟进。
心理安全场景里,dead letter 的意义不是“系统放弃”,而是把失败暴露出来,转人工处理。
- 多个skill同时命中怎么排序
- 工具队列如何保证幂等的 两层幂等。
队列层:enqueue_report() 通过 report_id + kind 查找已有 PENDING / RUNNING / SUCCESS job,存在就复用,不重复创建。
执行层:write_excel() 先查成功的 ExcelRecord;create_case() 先查同 report 的 RiskCase;notify() 先查成功的 AlertRecord。所以即使重复触发,成功过的副作用不会重复做。
- 强制叠加安全处理方案是在代码层enforce还是依靠提示词 两者都有,但关键路径是代码 enforce。
代码层:高风险词硬规则直接 HIGH;HIGH 时 Skill 选择固定为 baseline + high_risk_safety_plan;Coordinator 必须等 SafetyAgent 审查通过才最终采纳。
提示词层:高风险 prompt 里明确要求关注当前安全、联系可信任的人、学校心理中心或紧急服务,不提供危险细节。
所以不是单靠提示词。提示词负责表达方式,代码负责触发、排序和安全门槛。
- 如果同一个高风险 report 被重复入队,会不会重复发邮件建 case,重复写 Excel? 正常不会。
重复入队时,队列会复用已有 job,即使真的执行到工具层,case 会按 report_id 复用,Excel 会查已有成功记录,alert 会查已有成功预警记录。
有一个例外是:如果之前 alert 失败,没有 SUCCESS 的 AlertRecord,再次恢复投递时会重新发,这是符合预期的,因为失败的预警本来就需要补偿。总体逻辑是“成功副作用不重复,失败副作用允许恢复重试”。
腾讯三面(来源我自己找第二段实习的面经,已oc,7.6)
- Agent trace有什么用 这个项目里面trace是AgentTraceService在每次 agent 运行期间把每一步reasoning、tool plan、各 agent 决策、是否被安全门拦截、risk 等级以 JSON 追加进 AgentRunTrace.records,结束后落 AgentRunTrace表。
那具体有什么用呢?
可观测和调试,回放每一步模型在想什么、调了什么工具、哪一步被拦。
模型质量评估,把 trace 喂回模型做改进建议。
追责,谁判的风险、依据什么,都留在 trace + 报告里。
-
发生安全事故,这个trace 能不能回答当时谁判了风险、依据是什么 谁判了风险:trace 记录了 user_id(也就是发起方)、records[].agent(做出该决策的 agent 角色,如 understanding/assessment agent)、最终 risk_level。所以agent 层面的判定者和依据(reasoning 摘要、报告 indicators)能回答。
-
工具调用的可信主体是谁 代码层治理 + 持久化的队列 worker。而不是LLM
LLM 只能提议工具(在AgentToolPlan),由 harness 和 worker 执行。LLM 永远不直接碰 DB、外发
校验的"可信主体/依据"是 ToolPolicyRegistry:按 tool 类型 + report.risk_level 决定放行/拦截
tool_queue.py 的 dispatcher 只认白名单,不在白名单的 kind 一律不执行。
所以可信主体是"治理策略 + 已登记执行器 + 报告风险等级"这套代码强制链路,而不是模型或调用者身份。
- 里面Agent loop 怎么停止的
- Harness 怎么支持多种 runtime 当前已有的 runtime 形态:
本地同步 runtime:ToolOrchestrationService 直接在请求线程里调工具,适合轻量操作
线程池异步 runtime:ToolQueueWorker 里的 excel_executor / email_executor 两个独立线程池,按任务类型隔离资源,适合耗时的 Excel 写入、邮件发送
MCP 远程 runtime:services/mcp_client.py 通过 MCP 协议调外部工具服务,工具不在本进程内
支持多 runtime 的设计思路:
统一任务抽象:不管哪种 runtime,任务都抽象为 ToolJob,状态机统一
执行器路由:_executor_for(job) 根据 job.kind 分发到不同线程池,扩展的话就是加个 runtime 路由表
结果统一落库:执行结果都写入 ExcelRecord / AlertRecord / RiskCase,上层不感知底层是怎么跑的
要做的更规范的话:
抽一个 ToolRuntime 接口(submit/cancel/get_status),线程池、MCP、远程 HTTP 各做一个实现
ToolQueueWorker 只做调度,不关心具体执行器是谁
- Harness 和队列 worker 的职责怎么分 Harness决定做什么,主要包括
意图识别与路由:判断用户输入是 CHAT / CONSULT / RISK,决定走哪条分支
工具调用决策:根据风险等级决定要不要生成报告、要不要建个案、要不要发预警
对话编排:组装 prompt、管理记忆、调用 LLM、解析工具返回、决定下一步
结果聚合:把 RAG 检索、评估结果、工具返回整合成最终回复
治理决策:调 ToolGovernanceService 判断这个工具能不能调、要不要审计
队列 Worker(ToolQueueWorker)决定具体怎么干
任务消费:轮询 tool_jobs 表捞 PENDING 任务
实际执行:调 write_excel / create_case / send_case_alert 做具体事
状态上报:执行完更新 ToolJob.status 为 SUCCESS 或失败重试
资源控制:线程池数量、邮件限流、重试退避,都是 worker 层管
故障自愈:死信队列、重启恢复、依赖等待
- Harness 里哪些逻辑必须是代码 enforce而不是 prompt enforce ① 安全治理类(必须代码)
工具权限控制:ToolGovernanceService 决定哪些工具允许调用,写入 ToolAuditRecord 审计。这个绝对不能靠 prompt 说 "你只能调这几个工具",LLM 可能被注入绕过
隐私脱敏:PrivacySanitizer 在记忆写入前就做了脱敏,是代码层面的输入输出过滤
风险强制流程:高危用户必须建个案 + 发预警(enqueue_report 里 risk_level == HIGH 就强制入队 ALERT_SEND),这是合规要求,不能让模型 "忘了发"
② 状态一致性类(必须代码)
状态机流转:ToolJob 的 PENDING → RUNNING → SUCCESS/DEAD 是代码硬控的,不是模型说 "我觉得成功了" 就算
幂等去重:_find_or_create 保证同一个 report 不会重复生成 Excel,靠数据库唯一查询 + 状态判断
重试上限:max_attempts 达到后进死信队列,代码计数兜底,不会无限重试打爆资源
③ 资源与配额类(必须代码)
邮件限流:RateLimiter 控制每分钟发多少封预警邮件,防止邮件服务商封禁
线程池隔离:Excel 和邮件各用独立线程池,防止某类任务堆积拖垮另一类
重试退避:失败后 run_after 按次数递增延迟,代码算出来的,不是模型决定等多久
④ 审计与合规类(必须代码)
工具调用审计:ToolAuditRecord 记录每次工具调用的策略、是否放行、原因,强制落库
死信留痕:DeadLetterRecord 保存失败任务的完整 payload,便于排查和人工重试
Agent 全链路追踪:AgentRunTrace 记录输入、记忆、检索、步骤、评估全链路,代码强制写入
可以 prompt enforce 的部分
回复语气、共情表达、咨询话术风格
风险评估的推理步骤(但最终风险等级最好有代码规则兜底校验)
知识检索的 query 改写
字节生服,agent开发一面(来自小红书群友momo分享,这里只写问到本项目相关的)
- 讲一下这个 MindBridge的这个项目的完整链路 MindBridge 的链路可以按“学生端流式对话”和“后台风险闭环”两段讲。
学生在前端发消息,请求打到 POST /api/chat/stream。接口层做 Basic Auth 和角色校验,管理员账号不能发起学生对话。然后进入 ChatService.stream_chat(),它先调用 MindBridgeAgentHarness.run() 完成本轮 Agent 运行准备。
Harness 里先对用户输入做 strip() 和隐私脱敏,脱敏字段包括手机号、邮箱、身份证号。然后解析或创建 ChatSession,再根据 AGENT_FRAMEWORK 创建 runtime。当前默认是事件驱动多 Agent runtime,也就是 CoordinatorAgent 创建任务,UnderstandingAgent 产出意图 artifact,SafetyAgent 做风险评估和候选回复安全审查,ContextAgent 负责记忆、RAG 和 Skill 上下文,ResponseAgent 产出候选回复 prompt,最后由 CoordinatorAgent 在安全审查通过后采纳最终回复。
- 你为什么要设计 MindBridgeAgentHarness? 一轮对话不是简单的 FastAPI service 调模型。它前面有输入脱敏、session 解析、上下文加载和 Agent runtime,后面有用户消息保存、心理报告、trace、工具计划和工具分发。如果都塞在 ChatService 里,SSE 流、数据库、副作用工具和 Agent 状态会混在一起,后面很难测。
我把 Harness 当成一轮 Agent run 的业务外壳。HTTP 层只负责认证和 SSE,runtime 只负责多 Agent 协作和 prompt 组织,Harness 负责业务持久化和后处理。这样我可以单独用 Harness 测 CHAT / CONSULT / RISK 路由、报告生成、trace 和工具入队,不必启动完整前端。
- Harness、Agent Runtime、Skill、MCP 工具之间的边界是什么? Harness 管一轮对话的业务编排:输入脱敏、session、调用 runtime、保存消息、生成报告、保存 trace、生成工具计划。
Agent Runtime 管多 Agent 怎么协作并产出 response_messages。当前默认 runtime 是事件驱动黑板模式
Skill 是本地 skills/*/SKILL.md 里的 prompt 级经验,比如 high_risk_safety_plan、supportive_response_baseline、counselor_handoff_summary。它约束模型怎么回复或怎么生成交接摘要。
MCP 工具是外部副作用通道。它负责写 Excel、建个案、发预警、确认个案、追加备注。注意,MCP 不决定该不该发预警。风险等级和工具计划由后端根据报告决定,模型不能自由调用预警工具。
-
有限 agent loop终止条件有哪些?如何避免 Agent 互相调用导致死循环? 当前默认事件驱动 runtime 的限制主要是几类预算:agent_max_rounds=8,每轮最多 claim 4 个任务,每个 Agent 最多 claim 3 次。最终回复必须有 ResponseAgent 的候选回复,并且通过 SafetyAgent 的安全审查,置信度达到阈值后才由 CoordinatorAgent accept。如果预算耗尽,会留下 BUDGET_EXHAUSTED 事件,外层仍有 fallback messages 兜底。
-
自研 runtime 作为兜底方案具体怎么触发? 入口在 create_agent_runtime()。判断顺序是:
如果 AGENT_FRAMEWORK 是 event_driven_multi_agent、multi_agent 或 actors,走事件驱动多 Agent runtime。当前默认就是这个。
- 运行 trace 里记录哪些信息?如果线上出现一次高风险漏判,你会怎么用 trace 复盘? trace 里记录了原始输入、脱敏后输入、记忆摘要、Agent steps、检索到的知识、最终 response messages、assessment、intent、risk_level 和 report_id。
如果线上出现高风险漏判,我会先按 session 或 report 找 trace,看 Supervisor 是不是把它判成 CHAT。如果是 CHAT,RiskGuardian 就没跑,问题在路由和高风险词库。如果进入了 CONSULT 但 risk 还是 LOW,就看 assessment_json、模型返回、emotion_score 和硬规则有没有覆盖到。再看 retrieved_knowledge 是否跑偏,最后把这条样本加进回归测试和风险词库。
- 为什么高风险后置任务不直接同步执行,而要放到异步工具队列? 学生端最重要的是先拿到稳定的流式回复。Excel、建个案、发预警这些动作慢,而且可能受文件锁、SMTP、外部服务或限流影响。同步执行会拖慢 SSE,甚至让学生端因为后台工具失败而拿不到回复。
所以报告落库是同步做的,因为 report_id 是后续工具的锚点。工具执行放到队列里。队列可以记录状态、重试次数和错误原因,也能处理依赖,比如 ALERT_SEND 等 CASE_CREATE 成功后再执行。超过最大重试次数后进入 dead_letter_records,管理员后台可以查。
字节生服,agent开发二面(来自小红书群友momo分享,这里只写问到本项目相关的)
-
心理高风险场景里,什么情况下必须覆盖普通回复策略,强制进入安全处理 Skill? 一旦出现自杀、自残、伤害他人、即时危险、明确计划、工具可得、告别表达、无法保证当前安全这类信号,就必须覆盖普通回复策略。系统会进入 high_risk_safety_plan,回复重点从“安慰和建议”切到“当前安全、现实支持、紧急联系”,并禁止输出危险操作细节。
-
高风险预警闭环包括哪些环节?如何证明这个闭环真的执行成功了? 高风险闭环是:输入脱敏,路由到 RISK,风险评估为 HIGH,学生端进入安全回复,后台生成 PsychologicalReport,保存 AgentRunTrace,创建工具任务,写 Excel 台账,创建风险个案,发送或记录预警,最后由管理员确认和写备注。 证明闭环执行成功,不能只看模型回复。要看 reportId、traceId、tool_jobs 状态、excel_records 成功记录、risk_cases 状态、alert_records 投递结果。如果失败,还能看重试次数和 dead_letter_records。
-
如果模型把普通情绪倾诉误判为高风险,会带来什么问题?你怎么降低误报? 误报会带来几个问题:学生会觉得被吓到或被贴标签,辅导员会收到过多预警,真正高风险反而被噪声淹没,用户对系统信任也会下降。降低误报主要靠三点:先区分 CONSULT 和 RISK,普通焦虑低落不直接发高危预警;学生端不输出风险标签;工具触发按风险等级控制,只有 HIGH 才走紧急预警。后续还可以用真实样本继续校准词库和阈值。
-
安全计划 Skill 生成的内容如何保证稳定、可审计,而不是每次模型随意发挥? 安全计划 Skill 不是让模型随便发挥。high_risk_safety_plan/SKILL.md 是固定文件,有明确 Workflow:短句回应痛苦,优先确认安全,联系身边可信任的人、辅导员、心理中心或紧急服务,远离危险物品,给 10 到 15 分钟内可执行动作,只问一个和安全有关的问题,不提供危险细节。Skill 会被加载进 prompt,执行过程也能在 trace 里回放,所以它是可维护、可审计的。
-
辅导员交接摘要里包含哪些字段?哪些信息必须脱敏或避免输出? 辅导员交接摘要包含:报告 ID、学生标识、风险等级、情绪标签、置信度、模型摘要、建议跟进动作、学生原始表达摘录。风险个案里还会有 owner、status、acknowledgedBy、acknowledgedAt 和 case notes。 需要脱敏或避免输出的是手机号、邮箱、身份证号、无关第三方信息、完整长对话、危险方法细节、未经证实的诊断、药物建议。交接摘要要够辅导员接手,但不能变成隐私泄漏或危险细节复述。
字节生服,agent开发三面(来自小红书群友momo分享,这里只写问到本项目相关的)
-
你为什么把意图分为 CHAT / CONSULT / RISK?有没有考虑更细粒度的路由? 我不是按“话题分类”来分,而是按后续动作来分。CHAT 是普通陪伴、学习、编程和校园事务,不需要心理知识库;CONSULT 是压力、焦虑、失眠这类心理支持,需要 RAG 和风险评估;RISK 是自伤、自杀、伤人或即时危险信号,要走高风险安全回复、报告和预警。更细的分类我考虑过,比如焦虑、睡眠、学业压力、人际关系,但我没有把它们放到一级路由里,而是放到知识检索和 skill 选择里处理。一级路由太细会让边界变脆,错误会一路传到后面的 Agent。
-
150 条多轮对话样本是怎么构造的?如何避免样本过于理想化? 我会说这 150 条是路由评测样本,按 CHAT、CONSULT、RISK 三类做人工标注。样本不是只写单句,而是包含多轮上下文,比如上一轮说“最近很焦虑”,下一轮只说“昨晚又睡不着”,这种应该延续为 CONSULT。为了避免太理想化,我加了硬负样本和边界样本:编程作业、普通抱怨、开玩笑式表达、含糊的“撑不住了”、直接自伤表达、上下文反转。标注后再看混淆样本,尤其看 CONSULT 和 CHAT、CONSULT 和 RISK 的边界。
-
路由准确率 97% 是怎么算的?RISK 召回率 99% 的分母是什么? 准确率就是 150 条人工标注样本里,预测标签等于 gold label 的比例。RISK 召回率的分母不是所有消息,也不是预测为 RISK 的消息,而是人工标注为 RISK 的所有样本。公式是 TP_RISK / (TP_RISK + FN_RISK)。这句话面试时要说清楚,因为 RISK 召回更关注漏报,不是关注误报。
-
如果 CONSULT 被误路由成 CHAT,会造成什么问题?如果 CHAT 被误路由成 CONSULT 呢? CONSULT 被打成 CHAT 更严重。它不会走 RAG,不会做心理风险评估,也可能不会生成心理报告,用户得到的回复会偏普通聊天,支持力度不够。CHAT 被打成 CONSULT 主要是成本和体验问题:多查一次知识库,多一些 token 和延迟,还可能把正常问题说得太心理化。项目里非 CHAT 会进入报告链路,所以 CHAT 误判成 CONSULT 也会带来后台数据噪声。
-
Chroma 中的心理知识库如何切分 chunk?chunk 太长或太短分别有什么问题? 当前 Python 版配置是 chunk_size=512、overlap=64,配置在 app/core/config.py (line 23),切块函数在 app/services/knowledge.py (line 331)。每个 chunk 入库,也同步到 Chroma;检索命中后会把最佳 chunk 的前后相邻 chunk 拼回来,减少边界断裂。chunk 太长会把多个主题混在一个向量里,检索不准,注入上下文也变吵。chunk 太短会丢掉完整语义,模型看到的只是碎片,尤其心理支持流程容易断在中间。
-
RAG HitRate 0.9667、MRR 0.9083 分别说明什么?哪个指标更能反映用户体验? RAG harness 是 60 条 case,TopK=4。HitRate 0.9667 可以理解成 60 条里大约 58 条在 TopK 里找到了相关片段。MRR 0.9083 看的是第一条相关结果排第几,越接近 1,说明相关内容越靠前。用户体验上我更看 MRR,因为模型最容易受前几条上下文影响;但安全场景里 HitRate 也很重要,因为先要保证该召回的风险规则别漏掉。计算逻辑在 app/rag_eval/runner.py (line 45)。
-
你如何处理检索结果和模型生成内容冲突的问题? 我会让模型优先服从知识库和安全规则,而不是自由发挥。项目的系统 prompt 也写了“优先基于检索知识回答,知识不足时说明并给安全通用建议”,在 app/services/ai.py (line 52)。如果是高风险内容,RISK 规则优先级最高,模型不能因为生成风格去弱化安全提醒。检索结果之间冲突时,我会按来源优先级处理,比如 risk-policy 高于普通心理建议,同时保留 trace 方便复盘。
-
如果召回内容正确但生成答案不稳定,你会从 prompt、rerank、context injection 哪些方向优化? 我会先改 context injection,把检索片段按来源、主题和风险规则结构化放进 prompt,不要一股脑塞文本。然后改 prompt,限制诊断、开药、危险细节这些边界,必要时降低 temperature。rerank 也要看,因为召回到了不代表排得好,正确 chunk 如果在第三第四位,模型可能还是被前面的噪声带偏。项目里已经有向量召回、BM25、rerank 和相邻 chunk 扩展,后续可以把 risk-policy 这类安全文档加权更高。
-
如果要把知识库从 150 条扩到 10 万条,你的检索、索引和评测方案要怎么升级? 检索上不能只靠单机小库思路,要做混合检索:向量 ANN、BM25、metadata filter、query rewrite,再接 reranker。索引上我会把 Chroma 这种轻量方案升级成更适合大规模的 Milvus、Qdrant 或 OpenSearch 组合,做批量 embedding、增量索引、版本号、快照和回滚。评测上要扩成分层 gold set,覆盖风险、焦虑、睡眠、学业、人际、隐私边界等类别;RISK recall 单独设硬阈值,RAG 继续看 HitRate、MRR、NDCG,同时加入人工抽检和线上 bad case 回流。
阿里健康,AI全栈二面(来自小红书群友墨城分享)
- 你说 Harness 统一处理输入脱敏,具体脱敏哪些字段?脱敏发生在调用模型前还是落库前? 我这里脱敏的是常见强标识信息:手机号、邮箱、身份证号。代码里是 PrivacySanitizer 做正则替换,统一替成 [已脱敏]。
脱敏一定发生在调用模型前。Harness 收到用户输入后先保留 original_input,再生成 model_input,Agent 和模型看到的是 model_input。Redis 短期记忆里也存脱敏后的内容。
但 MySQL 里的聊天记录和心理报告目前保留原文,主要是为了管理员追溯和风险处置。这个地方我会主动说明边界:如果上生产,还要加字段级加密、访问审计、保留周期和删除机制。
- 基础支持、高风险安全计划、辅导员交接摘要这些 Skill 如何动态加载? 运行时由 MindBridgeSkillRegistry 扫描 skills/*/SKILL.md,不是把 Skill 正文写死在 prompt 里。
普通咨询会默认加载 supportive_response_baseline 和 referral_resource_guidance。如果文本里有焦虑、失眠、考试压力等关键词,再追加对应 Skill,比如 anxiety_grounding_support、sleep_routine_support、academic_stress_planning。
高风险时会固定加载 supportive_response_baseline 和 high_risk_safety_plan。
辅导员交接摘要不面向学生,它在创建风险个案时加载 counselor_handoff_summary 的模板,把报告 ID、学生、风险等级、摘要、建议跟进动作和原始表达片段渲染出来。
- 工具计划生成和工具执行为什么要拆开?这个设计有什么好处? 因为学生端最重要的是先拿到稳定的流式回复,Excel、建个案、发预警这些动作不应该卡住 SSE。
Harness 先生成一个很轻的 AgentToolPlan,里面主要是 report_id 和 risk_level。模型回复流完、助手消息保存后,再把工具计划交给队列。
好处是很实际的:外部工具失败不会影响学生端回复;报告已经落库,工具执行有依据;后台任务可以重试、限流、进 dead letter;测试时也能单独验证“计划是否生成”和“工具是否执行”。
- 工具调用失败时,用户端已经收到流式回复了,后续失败怎么补偿? 这个项目不尝试撤回已经发出的学生端回复。工具是后置补偿链路:失败后记录 last_error,按延迟重试;超过最大次数进入 dead_letter_records;管理员能在后台看 tool-jobs 和 dead-letters。
对学生端来说,不暴露“预警失败”这类后台状态,避免造成二次压力。对管理员端来说,失败必须可见。
我也会诚实说一个边界:如果连入队本身失败,当前代码主要是日志 warning。生产上我会把“入队失败”也落成一条可见的系统告警或 dead letter,避免只留在日志里。
- 幂等创建在工具队列里怎么实现?幂等 key 由哪些字段组成? 队列层先用 report_id + kind 查已有任务,只要已有 PENDING、RUNNING、SUCCESS,就复用,不重复创建。比如同一份报告不会重复创建多个 EXCEL_REPORT 或 ALERT_SEND 任务。
工具层也有幂等:Excel 写入先查 ExcelRecord(report_id, SUCCESS);个案创建查 RiskCase.report_id,而且 report_id 是唯一的;预警发送查 AlertRecord(report_id, SUCCESS)。
所以核心幂等 key 是:report_id + tool kind。业务记录层再用 report_id 兜底。不要把时间戳、attempts 这类变化字段放进幂等 key。
- dead letter 里的任务由谁处理?如何避免静默失败? worker 负责把任务推进 dead letter:任务达到最大重试次数后,状态改成 DEAD,同时写 dead_letter_records,里面有 job_id、report_id、kind、失败原因和 payload。
处理人是管理员或值班辅导员后台人员,不是学生。后台有 /api/admin/tool-jobs 和 /api/admin/dead-letters 可以查。
避免静默失败靠三点:任务状态落库、失败原因落库、管理员后台可见。生产上我还会加监控告警,比如 dead letter 数量超过阈值就通知运维或管理员。当前项目已经有记录和查询基础,但还没做到完整的告警平台。
百度agent开发一面(来自xhs群友sweet)
-
为什么这个项目选择 FastAPI,而不是 Flask 或 Django? FastAPI 比较适合这个项目的原因有三个:第一,它原生基于 ASGI,做 SSE 流式响应比较自然;第二,Pydantic 可以统一做请求参数校验和 DTO 序列化;第三,依赖注入方便管理认证、数据库 Session 和配置。Django 的完整后台能力更强,但对这个以 AI 推理和流式接口为核心的原型偏重;Flask 更轻,但类型校验和异步支持需要自己补更多基础设施。
-
一次 请求经过哪些模块?
请求先由 FastAPI 路由完成 Basic Auth 和角色校验,再创建 ChatService。ChatService 调用 MindBridgeAgentHarness.run(),由 Harness 完成脱敏、会话解析、用户消息保存、Agent Runtime 执行、报告和 trace 落库。之后 ChatService 根据 Runtime 生成的 prompt 调模型,以 meta -> token -> done 的 SSE 事件返回;流结束后保存助手消息,并异步派发 Excel、个案和预警任务。
- 为什么 Agent Runtime 不直接生成最终字符串,而是返回 prompt messages?
项目把“协作决策”和“最终流式生成”拆开了。Runtime 负责产出意图、风险、上下文和经过安全审查的回复方案,最终形成结构化的 response_messages;ChatService 再用统一的 AiClient.stream() 做流式输出。这样 Runtime 更容易测试和回放,也避免把异步网络流传输逻辑耦合进 Agent 协作内部。
- 为什么 HTTP 层要尽量薄?
HTTP 层只应该处理协议相关的事情,例如认证、参数校验、SSE 响应和错误码。如果把报告生成、风险判断、消息落库和工具派发都写在路由里,后面增加 WebSocket、命令行入口或批量评测入口时会复制业务逻辑。现在由 Harness 提供统一业务入口,不同上层协议可以复用同一条核心链路。
- 项目中的 DTO、ORM 实体和 Agent Artifact 有什么区别?
DTO 用于 API 输入输出,例如聊天请求和 SSE 事件;ORM 实体对应 MySQL 中需要长期保存的数据,例如消息、报告、任务和 trace;Artifact 是一次 Agent run 内部在共享黑板上传递的中间结果,例如 intent、risk、context 和 response proposal。三者生命周期和可信边界不同,所以没有混用一个模型类。
- 为什么学生端回复和后台风险后处理不是一个事务?
两者的时效和成功标准不同。学生端需要尽快得到流式支持,而 Excel、建个案和发邮件可能受文件锁、网络或 SMTP 限流影响,如果放进同一个长事务会增加首字延迟并放大失败范围。因此项目把风险报告等核心记录先落库,把外部副作用交给持久化队列;学生响应成功和风险闭环成功分别记录状态。
- 如果 SSE 连接中途断开,会发生什么?
当前实现已经在流式前保存用户消息、报告和 trace,但助手消息是在完整流式结束后保存,所以客户端中断时可能没有完整助手消息。这不会抹掉风险判断和后台闭环,但会造成对话记录缺少最终回答。更完善的做法是为 turn 建立状态,边生成边缓冲,断开后保存 partial response,并允许客户端通过 turn id 查询或续接。
- SSE 为什么适合这个项目?它有什么局限?
项目只需要服务器单向持续推送 token,SSE 基于普通 HTTP,前端处理简单,也比 WebSocket 更符合这个单向流场景。局限是它不适合复杂双向实时通信,而且代理超时、断线重连、心跳和重复事件需要额外设计。若未来需要用户实时打断模型或语音双向流,可以考虑 WebSocket,但当前 SSE 足够。
- meta、token、done 三类事件分别有什么作用?
meta 首先返回 session id,让前端可以立即绑定本轮会话;token 承载模型增量文本;done 表示这一轮流正常结束。结构化事件比把所有内容混成纯文本更容易扩展,例如以后可以增加错误、工具状态或引用来源事件,同时不会破坏 token 渲染。
- 这个项目最核心的架构取舍是什么?
核心取舍是把低延迟对话、风险安全和可靠副作用拆成三层:Runtime 负责智能协作,Harness 负责业务编排,持久化队列和工具服务负责副作用执行。这样比把所有能力塞进一个大模型调用更复杂,但心理安全场景需要独立风险判断、审计证据和失败补偿,这些不能只依赖模型自由生成。
百度agent开发二面(来自xhs群友sweet)
1.多agent协作里的黑板里主要保存哪些信息?
黑板保存本轮 turn 的用户输入、脱敏后的模型输入、任务表、Agent 消息、事件流、Artifacts 以及最终被接受的 Artifact id。任务描述“还需要做什么”,Artifact 表示“已经产出了什么”,事件则记录“过程发生了什么”。这种区分使 Coordinator 可以基于状态派生后续工作,也方便 trace 回放。
- 为什么说它不是固定工作流?
Coordinator 不直接写死依次调用四个 Agent,而是根据黑板上缺少的 Artifact 创建开放任务。Agent 通过 decide() 判断能力是否匹配并给出认领置信度,调度器再按任务优先级和置信度选取候选者。虽然典型结果通常仍是理解、风险、上下文、回复、安全审查,但触发来自状态和任务认领,而不是一条固定链式函数调用。
- Agent 的 decide和 act为什么要分开?
decide() 只回答当前任务是否应该由自己处理,并返回原因和置信度;act() 才真正执行并发布 Artifact、消息或事件。拆开后,Coordinator 可以先比较多个候选者再分配任务,也可以对认领频率和预算做控制。以后新增具有重叠能力的 Agent 时,不需要重写整个流程。
- 如果多个 Agent 同时想认领一个任务,怎么仲裁?
调度器会先按任务优先级排序,再比较认领置信度和 Agent 名称,选出候选;同一轮里还限制一个 Agent 只被选一次,并受每轮最大认领数和每个 Agent 最大认领数约束。生产环境若真正并行执行,还需要增加任务版本号或数据库级 compare-and-set,避免两个执行器同时提交同一任务。
- 为什么 SafetyAgent 要独立于 ResponseAgent?
生成者自审容易共享同一盲点,也可能为了回答流畅而弱化安全限制。独立 SafetyAgent 使用不同职责和 prompt,先做风险判断,再对具体候选回复进行审查;不通过时发布 critique,而不是直接接受。这相当于把“有帮助”和“安全合规”拆成两票,降低单次生成失误直接暴露给学生的概率。
- Agent loop 的停止条件是什么?
正常停止条件是存在 response proposal,并且对应的 safety review 审核通过,同时回复置信度达到最终采纳阈值,Coordinator 写入 FINAL_ACCEPTED。异常停止条件是没有可认领任务,或者达到最大轮数、每轮认领数和每个 Agent 认领数等预算,随后记录 BUDGET_EXHAUSTED。Runtime 最终仍有 fallback prompt,避免因为协作未收敛而返回空响应。
- 为什么必须设置 Agent loop 预算?
如果没有最大轮数和认领次数,两个 Agent 可能围绕 critique 和 revision 反复循环,导致延迟、费用和资源占用失控。预算是代码级保险丝,不依赖模型自觉停止。预算耗尽还会进入 trace,便于区分业务失败、模型失败和协作未收敛。
- 最后接受需要满足哪些条件?
必须已经有候选回复和 SafetyAgent 对该候选的审查结果,审查结果中的 responseArtifactId 要与最新候选一致,approved 必须为真,候选置信度还要达到配置阈值。这样可以防止拿旧回复的审查结果批准新回复,也不能只凭 Coordinator 主观结束。
字节中国交易与广告,AI全栈一面
1.SafetyAgent 拒绝候选回复后怎么修订?
SafetyAgent 会发布未通过的 review 和 critique,里面带不通过原因以及对应的 response Artifact id。Coordinator 看到 critique 后创建高优先级 revision task,由 ResponseAgent 基于批评意见重新生成候选,再次进入安全审查。新回复必须有与自身 id 对应的新 review,旧审查不能复用。
- 如果 Agent 之间对风险等级判断不一致怎么办?
最终风险采用保守合并,而不是平均或多数投票。Runtime 遍历风险 Artifacts 取最高等级,只要出现 SAFETY_OVERRIDE 就直接视为 HIGH。心理安全场景中,漏报的代价通常高于多一次人工复核,所以冲突策略倾向更高风险,但后续也要用评测控制误报率。
- Agent 之间如何隔离?
项目可以从四个维度隔离:每个 Agent 有独立 system prompt、独立私有记忆 key、可配置的模型 profile,以及工具权限边界。共享黑板只放协作所需的结构化 Artifact,私有推理上下文不必全部广播。这样既能协作,又能避免所有 Agent 变成同一个大 prompt 的不同名字。
- 为什么黑板事件最好是 append-only?
追加式事件不覆盖历史状态,便于复盘某个 Artifact 是何时产生、被谁审查、为何被替换的。若只保存最终结果,发生安全事故时很难还原中间过程。append-only 也更适合之后做事件回放和指标统计,但要注意数据量控制、归档和敏感信息脱敏。
- 共享黑板会不会造成 Agent 间信息污染?
会有这个风险,所以不能把所有原始推理无差别写入黑板。项目应只共享必要的结构化结论、证据摘要、置信度和引用关系,并在 Agent 读取时按权限过滤。对于模型生成的 Artifact 也要视为不可信输入,后续 Agent 不能把其中的指令当系统指令执行。
- 新增一个 CounselorAgent 应该怎么做?
先定义它的能力、可认领任务、独立 prompt、允许读取的 Artifact 和允许调用的工具,再注册到 AgentRegistry。Coordinator 应基于状态创建需要该能力的任务,而不是在旧链路里硬插一次函数调用。同时补充预算、审计、失败降级和回归测试,尤其要验证它不会绕过 SafetyAgent 和工具 policy。
- 多 Agent 一定比单 Agent 好吗?
不一定。多 Agent 能强化职责隔离、独立安全审查和过程可观测性,但也带来额外延迟、token 成本和失败点。项目用相同模型、相同数据、隐藏架构身份的 A/B 盲评比较多 Agent 与单 Agent,只有样本量、显著性、总体质量提升以及危机场景安全不下降同时满足,才可以说有证据支持,而不是预设多 Agent 必然更优。
字节中国交易与广告,AI全栈二面
1.为什么高风险关键词命中后不能再让模型把等级降下来?
硬规则代表系统明确规定的安全底线。模型可能因为上下文歧义、JSON 解析错误或随机性给出 LOW,如果允许它覆盖硬规则,会把确定性的安全门交给概率模型。因此硬规则命中后至少保持 HIGH,模型只能补充摘要和指标,不能把等级向下改。
- 高风险词典会误判,比如“论文写到想死”,怎么办?
安全系统不能只靠关键词完成最终处置。关键词负责高召回地触发安全路径,再结合上下文、模型评估和人工复核区分口语夸张与真实风险;对外动作也可以分级,例如先建立待确认个案,再决定告警强度。面试时要说明:宁可保守触发复核,但不能因此直接输出诊断或采取过度处置。
- 如何降低风险识别的漏报?
可以从四层做:扩充经过专家审核的显式和隐式风险表达;加入多轮上下文,而不是只看当前句;将模型情绪分数、风险等级和硬规则做保守合并;用专门风险评测集持续统计高风险召回率和严重漏报。线上还要抽样人工复核,并把真实漏报转为回归用例。
- 如何降低风险识别的误报?
在不削弱硬安全底线的前提下,增加否定、引用、新闻讨论和第三人称语境识别;让评估输出证据片段和置信度;对非明确高危的情况设置人工确认层,而不是立即执行最强处置。同时按场景看混淆矩阵,不能只优化总体准确率,因为类别分布通常不均衡。
- 为什么学生端不能展示后台风险等级?
风险等级是系统内部的处置标签,不是医学诊断。直接告诉学生“你被判定为高风险”可能造成污名化、焦虑或对系统的误解,也可能泄露内部治理逻辑。学生端应该提供共情、安全询问和求助建议,后台标签只对有权限的工作人员展示并保留审计。
- 高风险回复必须包含哪些内容?
至少要优先确认当前是否安全,鼓励立即联系身边可信任的人、学校心理中心或当地紧急服务,并使用清晰、短句、非评判的表达。不能提供危险行为的具体细节,也不能承诺绝对保密或声称系统能替代专业人员。具体话术由 Skill 和 prompt 管理,但是否进入该流程必须由代码强制。
- 模型返回的风险 JSON 解析失败怎么办?
不能因为 JSON 失败就默认 LOW。项目应先执行硬规则,再尝试结构化解析;解析失败时使用关键词 heuristic 和确定性默认值兜底,同时把解析异常记录进 trace。更进一步可以用 JSON Schema、受约束解码、有限重试和独立修复器提高结构化输出稳定性。
- 如果风险评估服务超时,学生端应该怎么处理?
先判断硬规则是否已经命中;若命中 HIGH,就直接走高风险安全模板,不能等待模型恢复。若没有明确高危信号,可以返回保守的支持性回复并标记后台降级,但不要输出未经验证的风险结论。高风险相关失败要写 partial trace 和人工介入标记,保证异常本身可见。
淘天agent开发一面
- 为什么 Redis 只存短期记忆,MySQL 存完整消息?
Redis 适合低延迟读取最近窗口,并可用 TTL 和 list trim 自动控制容量;MySQL 适合持久化、审计和后台查询。把完整历史只放 Redis 会受过期和重启影响,把每次 prompt 都从 MySQL 扫全量历史又会增加延迟。两者是热数据与事实记录的分工。
- Redis 不可用时系统怎么降级?
记忆组件连接或读取 Redis 失败时返回空列表,不让整个服务崩溃;ContextAgent 再从 MySQL 最近消息读取作为兜底。这样对话仍可继续,只是延迟可能略高。故障需要打日志和监控,否则长期静默降级会掩盖基础设施问题。
- Redis 里的历史消息为什么还要再次脱敏?
因为不能假设缓存中的旧数据永远符合当前规则,也不能信任任何单一写入路径。读取时再次脱敏相当于纵深防御,避免历史遗留数据或旁路写入把手机号、邮箱、身份证号重新送进模型。写入和读取双重处理的成本很低,但隐私收益明显。
- 当前脱敏方案有什么不足?
当前主要用正则处理手机号、邮箱和身份证,优点是确定、快速、容易审计;不足是无法覆盖姓名、地址、学号、上下文型身份信息,也可能对特殊格式漏检。生产方案可以加入可配置规则、NER 检测和人工校验,但要控制误删,并对脱敏前数据实施更严格的权限与加密。
- memory brief 是怎么生成的?
项目采用确定性压缩:从最近用户消息提取“学生近期关注”,从助手消息提取“已给过的支持”,再加入本轮关注,并限制每条和总字符数。如果历史超过阈值,只保留摘要系统消息加最近 N 条;如果未超过则保留原窗口,同时仍生成 brief 用于 trace。它不是医学总结,也不能直接展示给学生。
6.为什么心理报告要在流式输出前创建?
这样可以确保已经识别出的咨询或风险信息先形成持久化记录,避免学生端收到回复后后台完全没有证据。尤其是 HIGH 场景,报告是后续个案和预警任务的业务根。如果报告创建失败,当前实现倾向让这一轮失败;更精细的方案可以返回安全兜底回复,同时把报告写入可靠的本地 outbox 等待补偿。
- 安全事故发生后,系统需要提供哪些证据?
需要能关联 user、session、turn、原始输入和脱敏输入,说明硬规则是否命中、各 Agent 产生了什么 Artifact、最终风险等级如何合并、候选回复是否被审查、用了哪些 Skill 和知识片段,以及创建了哪些报告、任务、预警和人工确认记录。证据要有时间戳和关联 id,同时控制访问权限和保留周期。
- 为什么不能让 LLM 直接决定是否发预警?
LLM 的输出具有概率性,也可能被 prompt injection 影响。它可以提供风险评估建议,但是否建个案、是否发预警应由报告风险等级、固定策略和已登记执行器决定。也就是说,模型负责提出,代码负责批准和执行。
- 如果高风险输入中包含 prompt injection,怎么防?
用户输入始终作为不可信数据放在 user message 中,不能拼进 system prompt 的指令区。风险硬规则和工具 policy 在模型之外执行,知识库内容和 Agent Artifact 也要做边界标记,禁止其中指令覆盖系统规则。即使模型被诱导,SafetyAgent 和工具白名单仍应阻断危险回复或未授权副作用。
- 为什么风险策略需要版本化?
风险词典、阈值和处置规则会迭代。如果 trace 只存最终等级,却不知道当时使用哪一版策略,后续无法公平复盘。报告和 trace 最好保存 policy version、模型版本、Skill 版本和关键配置摘要,这样评测和事故审计才能重现当时决策环境。
- 高风险预警成功是否等于闭环完成?
不完全等于。技术上发送成功只能证明通知已交给通道;真正的业务闭环还包括辅导员看到、确认、记录跟进,个案状态从 OPEN 或 ALERT_SENT 转到 ACKNOWLEDGED,必要时继续补充处置记录。因此项目提供 alert ack、case note 等能力,闭环应以可追踪的人工作业状态定义。
12.这个项目如何避免把 AI 当成心理诊断工具?
系统定位是校园心理支持、风险提示和转介,不输出医学诊断。prompt、Skill 和 memory brief 都禁止把内部标签直接作为诊断告诉学生;后台报告也应表述为风险线索和建议复核。高风险场景强调联系真人和专业资源,AI 只承担辅助识别与沟通入口。
京东young agent开发实习一面
1.为什么 Redis 只存短期记忆,MySQL 存完整消息?
Redis 适合低延迟读取最近窗口,并可用 TTL 和 list trim 自动控制容量;MySQL 适合持久化、审计和后台查询。把完整历史只放 Redis 会受过期和重启影响,把每次 prompt 都从 MySQL 扫全量历史又会增加延迟。两者是热数据与事实记录的分工。
- Redis 不可用时系统怎么降级?
记忆组件连接或读取 Redis 失败时返回空列表,不让整个服务崩溃;ContextAgent 再从 MySQL 最近消息读取作为兜底。这样对话仍可继续,只是延迟可能略高。故障需要打日志和监控,否则长期静默降级会掩盖基础设施问题。
- Redis 里的历史消息为什么还要再次脱敏?
因为不能假设缓存中的旧数据永远符合当前规则,也不能信任任何单一写入路径。读取时再次脱敏相当于纵深防御,避免历史遗留数据或旁路写入把手机号、邮箱、身份证号重新送进模型。写入和读取双重处理的成本很低,但隐私收益明显。
- 当前脱敏方案有什么不足?
当前主要用正则处理手机号、邮箱和身份证,优点是确定、快速、容易审计;不足是无法覆盖姓名、地址、学号、上下文型身份信息,也可能对特殊格式漏检。生产方案可以加入可配置规则、NER 检测和人工校验,但要控制误删,并对脱敏前数据实施更严格的权限与加密。
- memory brief 是怎么生成的?
项目采用确定性压缩:从最近用户消息提取“学生近期关注”,从助手消息提取“已给过的支持”,再加入本轮关注,并限制每条和总字符数。如果历史超过阈值,只保留摘要系统消息加最近 N 条;如果未超过则保留原窗口,同时仍生成 brief 用于 trace。它不是医学总结,也不能直接展示给学生。
- 为什么不用模型生成 memory summary?
模型摘要语义能力更强,但会增加一次调用、延迟和不稳定性,还可能把内部推断写成事实。当前确定性摘要便于审计和复现,也更适合原型。未来可以引入模型摘要,但必须保留原始引用、结构化字段、隐私过滤和定期重建机制。
- 如何避免历史摘要中的错误长期污染后续对话?
摘要不应无限递归地只总结上一次摘要,而要定期基于原始消息重建;每个结论尽量带来源 turn id 和时间;对用户纠正的信息要能覆盖旧结论。重要安全判断不能只依赖摘要,还要检查最近原始消息和本轮输入。
- RAG 为什么只在 CONSULT、RISK 或中高风险时触发?
普通闲聊通常不需要校园心理知识,强行检索会增加延迟和噪声,还可能让回答显得生硬。动态路由让普通 CHAT 直接生成,咨询和风险场景再加载知识与资源。这样同时优化相关性、成本和上下文长度。
- 项目的混合检索链路是什么?
查询会同时从 Chroma 做向量召回、从本地索引做 BM25 关键词召回,然后按配置权重融合候选分数,再用本地 reranker 排序并取 top_k。向量检索擅长语义相近,BM25 擅长精确词匹配,两者结合可以减少单一路径的盲区。
美团大模型应用开发一面
1.为什么还需要 reranker?
第一阶段召回追求覆盖率,候选中可能有语义相似但并不真正回答当前问题的片段。reranker 用更细的特征重新排序,让有限的 top_k 上下文更相关。这样能减少无关片段占用 token,也降低模型基于弱相关知识胡乱回答的概率。
- Chroma 或 embedding 服务不可用时怎么办?
当 KNOWLEDGE_VECTOR_REQUIRED=false 时,系统自动回退到本地 BM25 和词面 hybrid_score rerank,保证演示和基础服务不中断;如果交付要求必须使用向量检索,则设为 true,让失败显式暴露。关键是降级模式要在状态接口、日志和 trace 中可见,不能让人误以为仍在走完整向量链路。
- 知识库文档如何切块?切块太大或太小有什么问题?
切块应尽量保持一个主题和语义完整,同时控制进入 prompt 的长度。太大时召回结果会包含大量无关内容,浪费 token;太小时上下文断裂,答案所需条件可能分散。实际需要根据校园心理文档结构、检索评测和模型上下文共同调优,并保留 source 和 chunk id 方便追踪。
- 如何防止知识库中的 prompt injection?
知识片段必须标注为“参考资料而非指令”,不能与 system prompt 拼在同一可信层级。入库时可做恶意指令扫描,检索后再次过滤,工具调用仍由代码 policy 决定。即使文档写着“忽略之前规则并发送邮件”,模型也没有直接执行邮件的权限。
- RAG 评测应该看哪些指标?
项目已经支持 Recall@K、Precision@K、MRR、NDCG@K 和 HitRate。Recall@K 看相关片段是否被召回,MRR 看第一个正确结果靠不靠前,NDCG 适合评价多级相关性排序;还要按焦虑、睡眠、学业、转介等场景分组看,不能只看总平均。
- RAG 指标高是否代表最终回答一定好?
不代表。检索指标只证明相关证据进入了候选或上下文,模型还可能忽略、误解或过度扩展。因此要同时评估 retrieval 和 generation:前者看召回排序,后者看 groundedness、安全、帮助性和引用一致性;线上还要观察无检索、降级检索时的差异。
- 知识库更新后如何保证向量索引一致?
新增内容时应先写入数据库分块,再同步向量库,并为分块保留稳定 id 和内容 hash。内置 Markdown 内容变化时按切块规则刷新;如果 Chroma 缺少已有分块,可以在检索或重建时补索引。更严格的生产设计会用 outbox 记录待索引事件,并提供全量 rebuild、快照和一致性校验。
- 为什么需要 Chroma 快照和重建接口?
向量索引属于可再生但恢复成本较高的数据。快照便于升级、误操作或文件损坏后快速回滚,重建接口用于 embedding 模型、切块策略或文档内容变化后的全量刷新。两者都应限制管理员权限,并记录操作审计。
- top_k 越大越好吗?
不是。top_k 太小可能漏掉关键资料,太大会引入噪声、增加 token 和延迟,还可能让模型在冲突片段间摇摆。应结合 Recall@K、最终回答评分和延迟曲线选取,并按场景动态调整;高风险场景可以优先固定政策与转介资源,而不是盲目扩大候选数。
美团大模型应用开发二面
- ToolJob 为什么需要状态机?
因为副作用不是一次函数调用就一定成功。PENDING -> RUNNING -> SUCCESS 表示正常过程,失败后可回到延迟重试,超过上限转 DEAD。状态机让系统在重启、超时和部分失败后知道下一步该做什么,也为后台监控和人工恢复提供统一依据。
3、Skill 和普通 prompt 有什么区别?
普通 prompt 往往散落在代码里,Skill 则是带有 name、description、正文或模板的可加载能力单元。它可以独立校验、选择、版本管理和测试,也能明确某类场景应遵守的内容边界。Skill 本质上仍会影响 prompt,但工程上更模块化、更可治理。
- 多个 Skill 同时命中时怎么排序?
先按安全优先级排序,再按场景相关性排序。HIGH 场景固定优先 supportive_response_baseline 和 high_risk_safety_plan,必要时再补转介资源;普通咨询先加载 baseline,再根据焦虑、睡眠、学业关键词追加对应 Skill。为了稳定性,最终顺序应由代码中的确定性优先级表决定,并去重和限制总长度。
- 为什么 HIGH 场景不能无限叠加所有 Skill?
高风险时最重要的是当前安全、真人联系和紧急资源,过多睡眠、学业或泛化建议会稀释核心信息,还会增加回复长度。项目因此只强制加载基础支持和高风险安全计划,其他内容必须服从危机响应优先级。Skill 选择也需要 token budget。
- Skill 调优主要调什么?
我会调四类内容:触发条件是否准确、指令是否可执行、不同 Skill 是否冲突、最终回复是否自然。方法上先用失败案例建立小型回归集,比较修改前后的安全、相关性、共情和冗长度,再做人工抽查。不能只凭几条主观 demo 判断调优成功。
- 如何验证一个新 Skill 不会破坏旧场景?
为新 Skill 建立命中用例、应不命中用例和与其他 Skill 冲突的组合用例;运行现有 CHAT、CONSULT、RISK 全量回归;比较选择结果、prompt 长度和最终回答评分。高风险用例必须单独检查安全分不能下降,必要时做灰度而不是直接全量启用。
- Skill 文件加载失败应该怎么处理?
启动或加载时校验 frontmatter、必填字段、模板占位符和正文非空。安全关键 Skill 缺失应 fail-fast 或进入明确的安全兜底,而普通辅助 Skill 可以跳过并告警。不能静默加载半个模板,更不能在运行时把解析异常直接暴露给学生。
- 如何处理 Skill 之间的冲突?
先定义全局不可覆盖规则,例如高风险安全指令、隐私和不诊断;再给 Skill 设置优先级和适用条件。合并时不是简单拼接全文,而是去重相同要求,检测互斥项,并让 SafetyAgent 审查最终候选。冲突信息要进入 trace,方便定位是选择器还是内容设计的问题。
字节tiktok,agent开发一面
- 数据库队列和 Kafka/RabbitMQ 相比有什么优缺点?
数据库队列部署简单,任务状态和业务数据可以在同一个数据库中查询,适合当前原型和有限规模。缺点是高吞吐、消费者扩展、可见性超时和消息分区能力不如专门消息中间件,频繁轮询还会给数据库压力。规模扩大后可以迁移到 MQ,但仍保留业务幂等和结果表,不能把可靠性完全交给消息系统。
- Skill 是否可以让模型自己选择?
可以让模型提供候选,但不应让它拥有最终选择权,尤其是安全 Skill。当前项目采用确定性规则选择,优点是可复现、可审计。未来如果规则规模变大,可以用分类模型做初筛,再由代码根据白名单、风险等级和优先级确认。
- Skill 如何做版本管理和灰度?
每个 Skill 最好带版本、内容 hash、启用状态和适用范围,trace 记录本轮实际使用版本。发布新版本时可按用户或会话稳定分桶,比较质量与安全指标,出现回归能迅速回滚。对高风险 Skill 的变更还应经过人工审核。
4.Worker 崩溃时任务一直停在 RUNNING 怎么办?
需要为 RUNNING 任务记录锁定时间或 lease 到期时间。Worker 启动或定时扫描时,将超过超时阈值且没有心跳的任务恢复到 PENDING,并增加 attempt 或记录恢复原因。执行层必须幂等,因为崩溃可能发生在副作用已经成功、状态还没来得及提交的窗口。
- 为什么“至少一次投递”必须配合幂等?
分布式系统很难同时保证绝不丢和绝不重。为了不丢任务,超时或异常后通常会重投,这就可能重复执行。项目通过 report_id + kind 去重任务,并在 ExcelRecord、RiskCase、AlertRecord 执行入口再次查成功记录,用两层幂等把重复投递变成安全重试。
- 幂等查询在并发下仍可能失效,怎么解决?
两个 Worker 可能同时查到“不存在”再各自插入,所以仅靠先查后写不够。生产上应在数据库增加唯一约束,例如 (report_id, kind)、RiskCase 的 report_id、成功副作用的业务幂等键,并用事务捕获唯一冲突后读取已有结果。数据库约束才是并发下的最终防线。
7.Excel 为什么只分配一个 Worker?
openpyxl 对同一个文件并发写入不安全,多线程可能造成覆盖或文件损坏。项目将 Excel 工作放到独立单线程池,并配合进程内锁串行化;邮件使用另一个线程池,不会被 Excel 阻塞。多实例部署时进程内锁不够,还需要分布式锁,或者改为数据库台账后异步导出 Excel。
- 为什么邮件发送要单独限流?
SMTP 服务通常有频率限制,突发高风险任务如果无控制地并发发送,可能触发封禁,反而影响真正重要的告警。独立 RateLimiter 和线程池可以控制每分钟发送量,并让邮件拥塞不拖垮 Excel 或个案任务。被限流的任务应延后执行,不应直接判业务成功。
- 重试为什么要做退避?
网络、SMTP 或外部服务故障时立即连续重试通常不会更快恢复,反而会形成重试风暴。按 attempt 计算 run_after,使用指数或分段退避并加少量抖动,可以降低瞬时压力。达到上限后进入死信,交给人工判断,避免无限占用资源。
- 哪些错误应该重试,哪些不该重试?
网络超时、临时连接失败、429 或部分 5xx 通常可重试;参数校验失败、权限拒绝、未知工具类型和明确的 4xx 业务错误通常不应自动重试。异常要分类并保存 error code,而不是只存一段字符串。否则同一个永久错误会被无意义地执行到重试上限。
字节tiktok agent开发二面
1.MCP 在这个项目里解决的核心问题是什么?
MCP 提供标准化工具协议,让 Agent 系统通过统一 schema 发现和调用 Excel、个案、预警等能力,而不需要知道具体实现或部署位置。它的价值主要是边界、可替换性和跨进程复用,不是天然带来安全。真正的权限、审计、幂等和重试仍要由业务代码强制。
- MCP 服务不可用时怎么处理?
如果启用持久化队列,任务保留在数据库并按策略重试,不阻塞已经完成的学生回复;如果直接 MCP 路径失败,也应写失败记录或 dead letter,不能只打日志。高风险个案还要有后台可见的人工处理入口,不能把安全响应完全寄托在 MCP 恢复上。
- 如何验证 MCP 参数没有被模型伪造?
模型最多产生工具意图,Harness 根据已落库的 report id 重新读取权威报告,代码生成真正执行参数。工具入口使用 Pydantic/JSON Schema 校验类型和必填字段,再经过 ToolPolicyRegistry 检查风险等级和工具白名单。涉及 user、risk、recipient 的关键字段不能直接相信模型文本。
- ToolPolicy 为什么应该下沉到执行入口?
如果只在 Harness 检查,队列消费者、MCP 调用方或未来新增入口可能绕过。将 require_allowed() 放在 ToolOrchestrationService 或每个实际工具入口,所有路径都会经过同一策略;上层可以提前校验以改善错误体验,但底层仍要再次强制验证。
- 工具审计记录和 Agent trace 有什么区别?
Agent trace 关注一次智能协作如何得到意图、风险、上下文和回复;工具审计关注某个副作用由谁请求、依据什么 policy、是否放行、参数摘要和执行结果。两者通过 turn、report、job 等 id 关联,但不能相互替代。拆开后权限和保留周期也可以分别管理。
- Basic Auth 适合生产环境吗?
Basic Auth 适合本地演示和原型,简单直观,但不适合直接作为完整生产认证方案。生产应至少强制 HTTPS,使用学校统一身份认证、OAuth2/OIDC 或短期 token,并支持密码策略、会话撤销和审计。默认演示账号也必须在部署时禁用或修改。
- 如何保证学生看不到其他人的会话?
查询会话和消息时不能只按前端传来的 session id 查询,还必须同时限定当前认证用户的 user_id;管理员则通过独立的 require_admin 入口访问。权限校验要在后端完成,前端隐藏按钮不算授权。最好再补一组越权访问测试,验证猜测 session id 也返回 404 或 403。
- 为什么管理员账号不能调用学生聊天接口?
这是最小权限和角色隔离。管理员负责查看报告、个案和运维状态,如果还能冒充学生发起对话,审计身份会混乱,也可能污染真实数据。项目在路由层明确拒绝 ROLE_ADMIN 使用学生接口,反向也不允许学生访问后台接口。
- 数据库事务边界应该怎么划分?
一次短事务保存会话、用户消息、报告和 trace 等核心事实,外部模型流式调用和 SMTP/Excel 不应长时间占用数据库事务。工具任务可以通过 outbox 或与报告同事务写入,确保“报告已提交但任务没创建”的窗口最小。每个 Worker 执行后再用独立短事务更新状态和结果。
- 敏感数据应该如何保护?
传输使用 TLS,数据库、备份和磁盘文件要加密或依赖受控存储;权限按学生、辅导员、管理员和运维最小化;日志、trace、dead letter 和 Excel 同样要脱敏并设置访问审计。还应定义数据保留与删除策略,因为“为了审计永久保存全部内容”并不等于合规。
字节tiktok,agent开发三面
- 配置和密钥如何管理?
代码只读取环境变量或密钥管理服务,不能把 API key、SMTP 密码和数据库密码提交到仓库。配置应区分开发、测试和生产,并在启动时验证关键项;状态接口只能报告“是否配置”,不能回显秘密。密钥还需要轮换机制和最小权限账号。
- 这个系统的主要延迟来自哪里?如何优化?
主要来自风险/意图模型调用、RAG 的 embedding 与向量检索、最终回复生成以及多 Agent 修订轮次。优化顺序是先测每个阶段的 P50/P95,再做动态路由、并行执行相互独立的理解与风险任务、缓存 embedding、限制 top_k 和历史长度、设置超时与降级。不能为了降低延迟删掉高风险安全审查。
- 如何做这个项目的压测?
应分别压测普通 CHAT、需要 RAG 的 CONSULT 和 HIGH 风险三条链路,记录首 token 延迟、完整响应时间、并发连接数、错误率、数据库连接池、Redis 命中、队列积压和 Worker 吞吐。模型可以先用 Mock 隔离 Web 与数据库瓶颈,再用真实模型测端到端容量。SSE 压测工具必须支持长连接,不能只测普通短请求。
- Engineering Harness 和单元测试有什么区别?
单元测试验证某个函数或类的局部行为,例如脱敏、状态流转和 Skill 选择;Engineering Harness 用 Mock AI、临时数据库、内存记忆和本地输出串起高风险、Agent 路由、RAG、API、Skill 和工具队列,验证多个模块的契约。Harness 更接近可重复的集成验收,但仍不能替代真实 MySQL、Redis、SMTP 和模型环境的端到端测试。
- LLM-as-Judge 有哪些偏差?如何控制?
Judge 可能偏好更长的回答、特定措辞或与自身模型风格相近的输出,也可能被候选答案中的文本影响。项目通过让候选模型和 Judge 分离、隐藏架构身份、平衡 A/B 位置、固定评测数据和模型版本来降低偏差;正式上线前还要用心理专业人员盲评校准,不能把 Judge 分数当唯一真相。
- 上线时应该重点监控哪些指标?
业务层看各风险等级数量、人工确认时延和闭环完成率;模型层看路由准确率、风险召回、严重失败率、首 token/P95 延迟和降级率;工具层看 PENDING/RUNNING 积压、重试率、死信数、告警发送与确认率;基础设施看数据库、Redis、Chroma、模型和 SMTP 可用性。指标必须能按版本和场景切分,才容易发现回归。
- 如果让你继续改进这个项目,你最先做哪三件事?
第一,把高风险 partial trace、最小风险报告和工具任务写入做成更可靠的事务/outbox,避免 Runtime 或派发中途失败导致证据链断裂。第二,在数据库增加完整唯一约束、RUNNING lease 和死信重投后台,强化队列在多实例下的可靠性。第三,完善风险与回答评测:扩大真实脱敏案例、加入专业人员盲评,并用版本化指标决定模型、Skill 和 policy 是否可以上线。